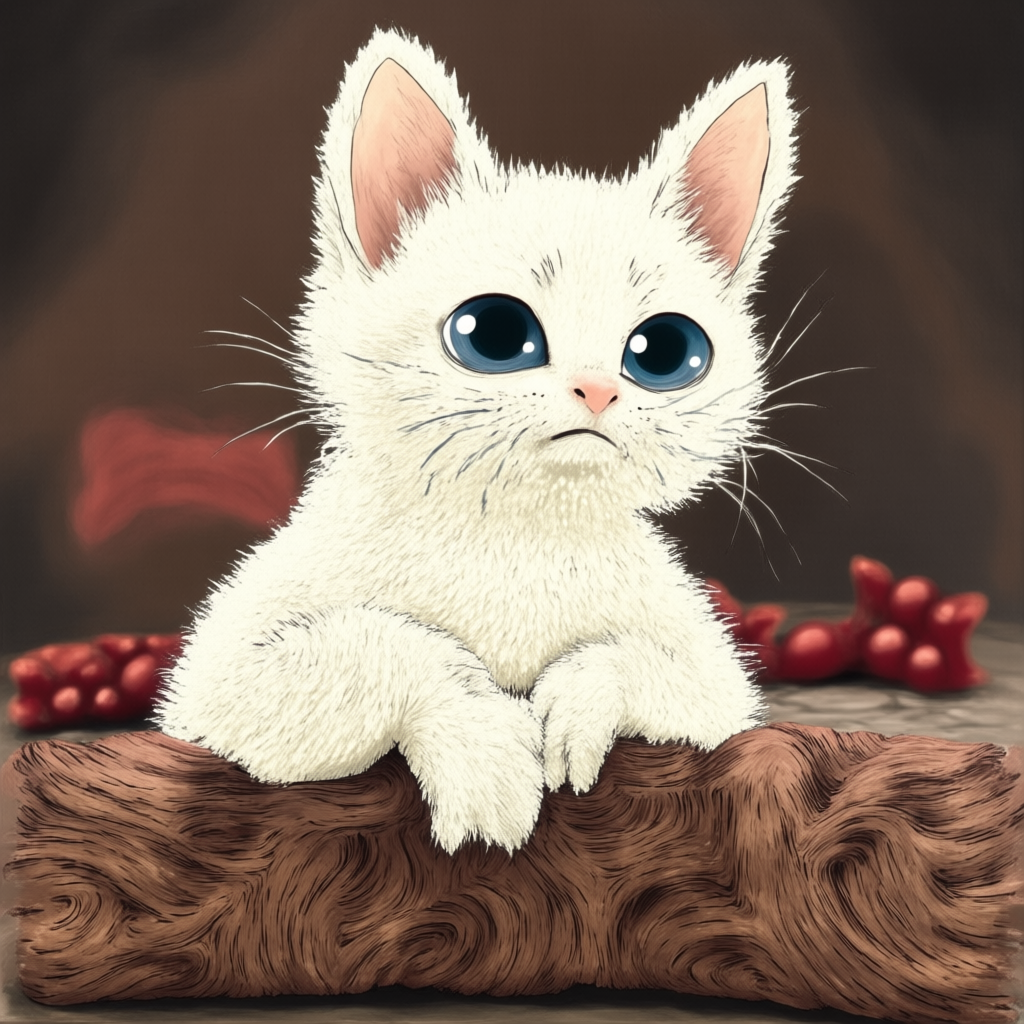
木刻参考
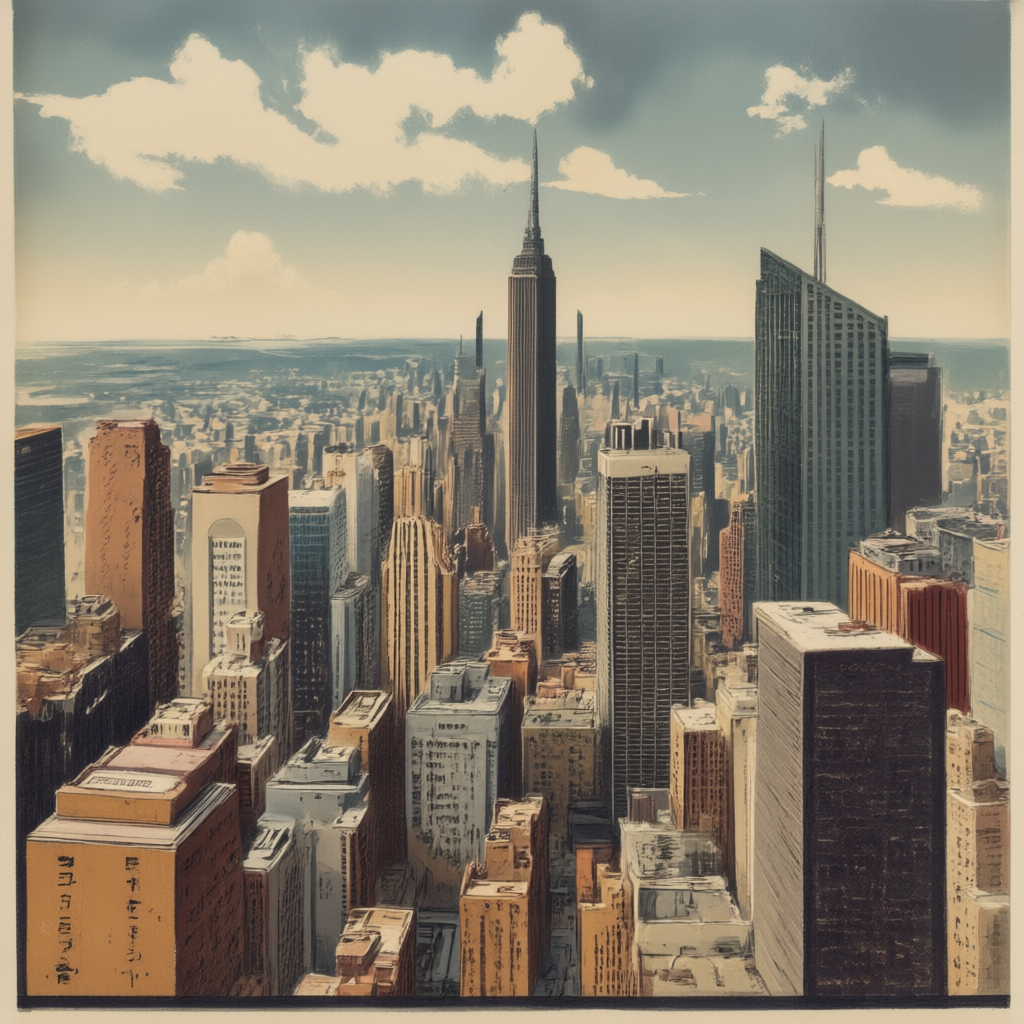
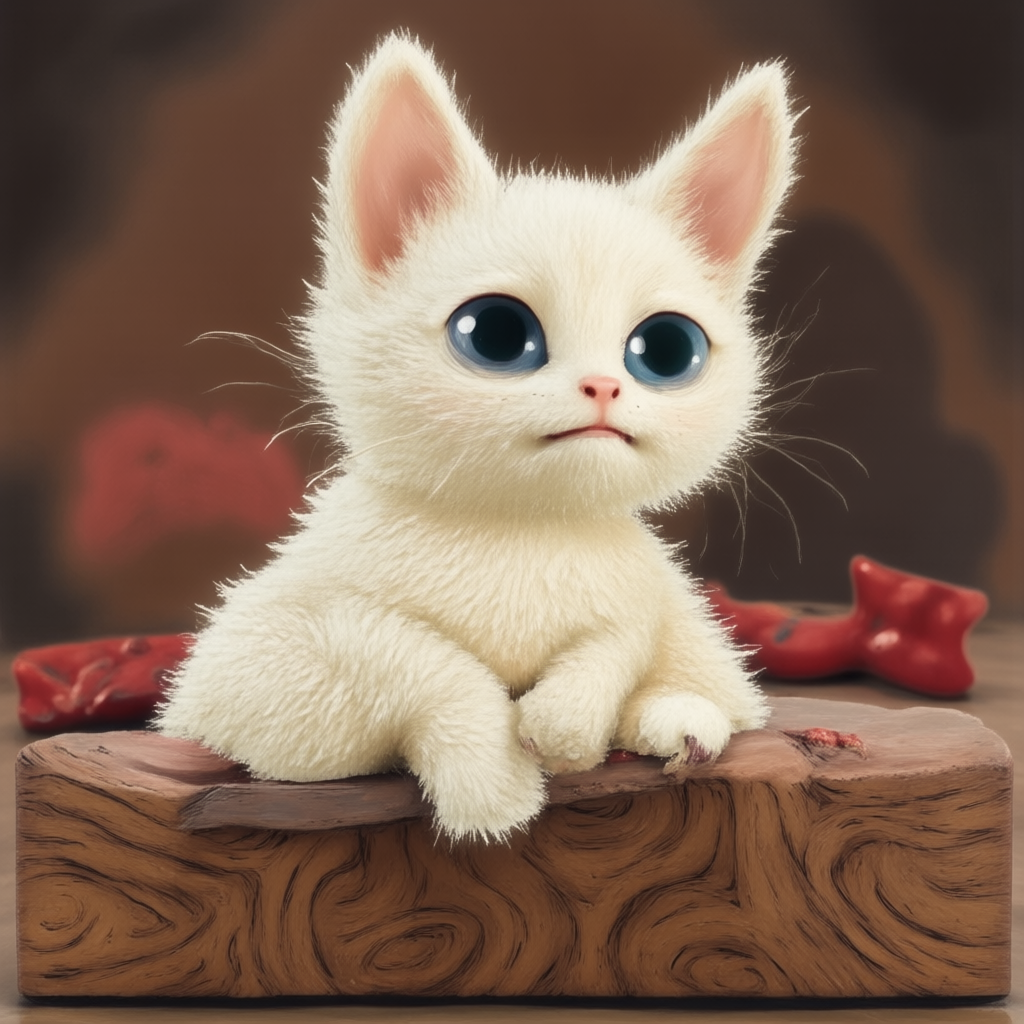
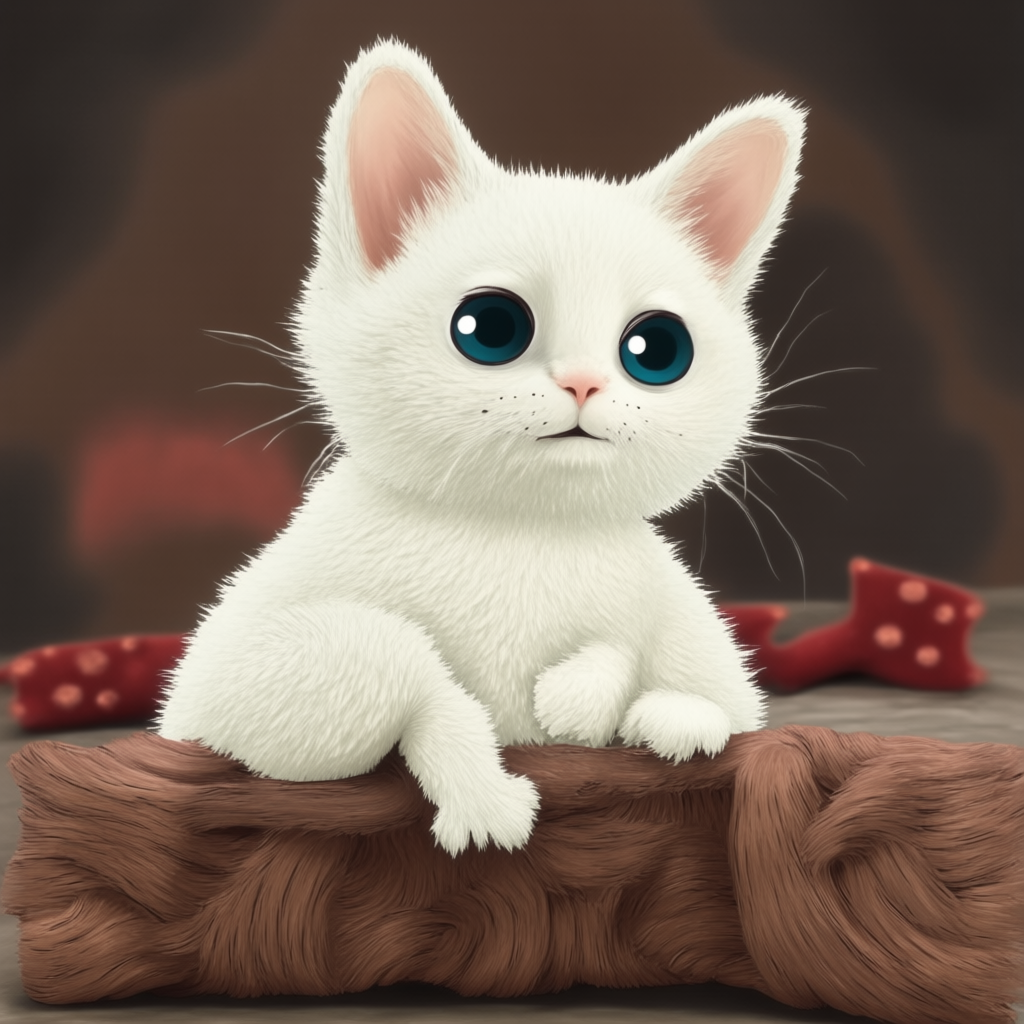
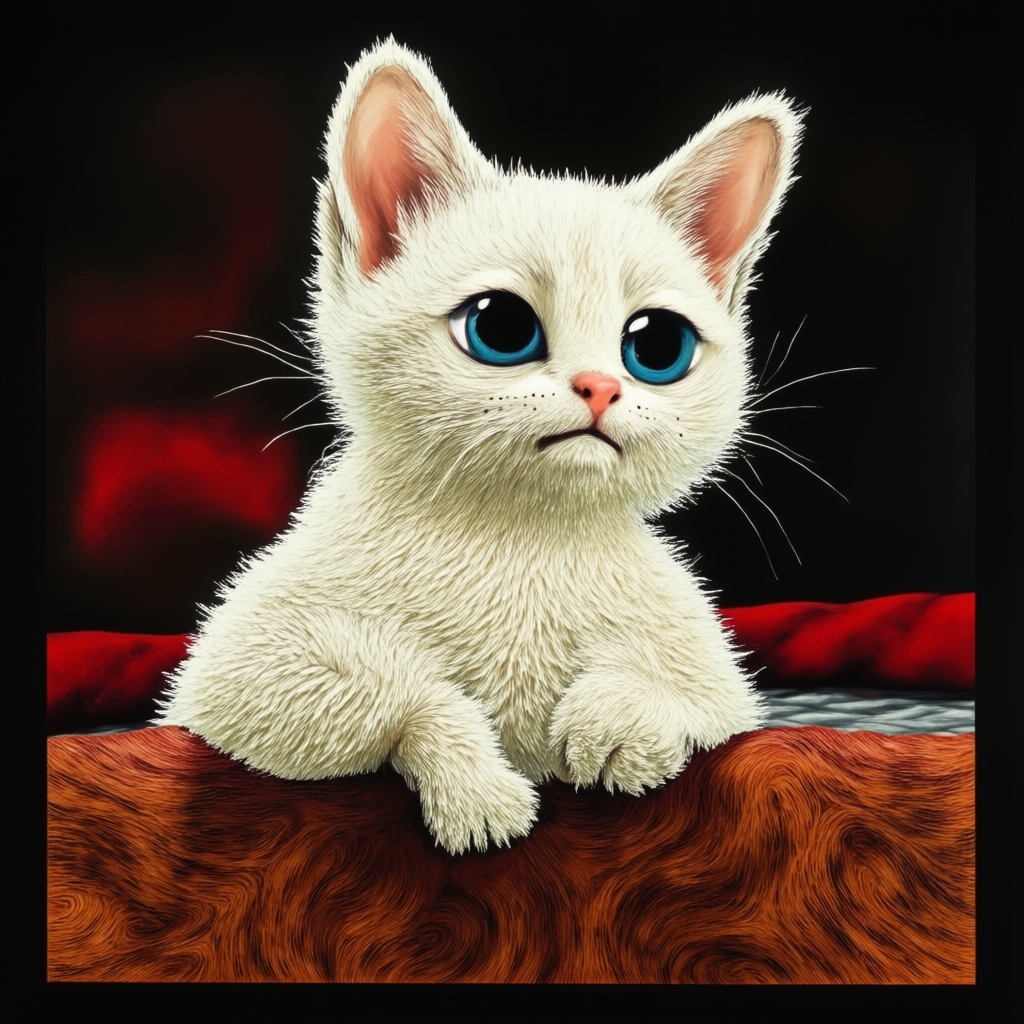
✦ 滑动或拖动查看更多真实输出 · LoRA 10788 · 选取案例
让同一张内容图保持主体与构图,同时尝试从不同参考图中迁移画风。下面既展示出现响应的结果,也展示笔触与材质仍然失配的案例。
固定内容图与随机种子,依次替换画风参考 A;左右滑动,直接比较参考与输出。
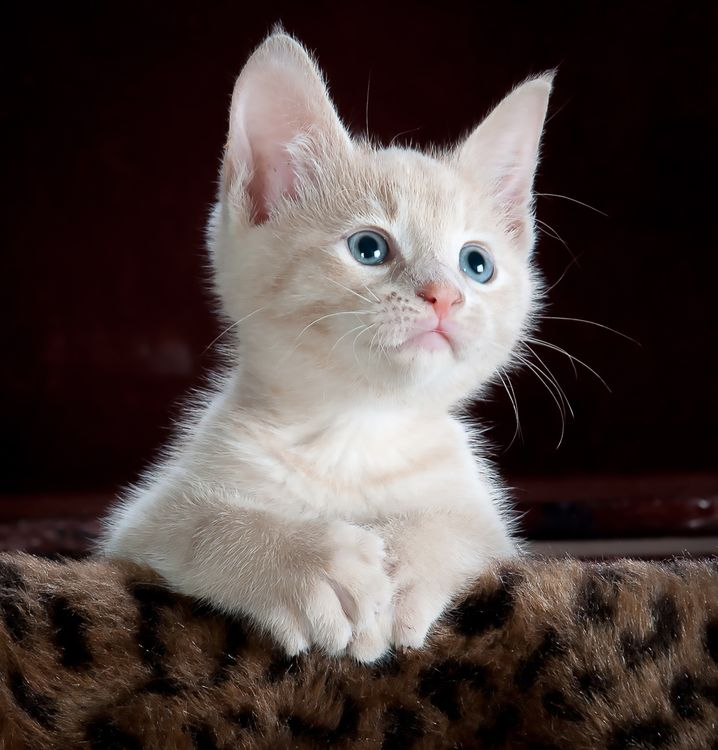 固定内容 B:同一张猫图
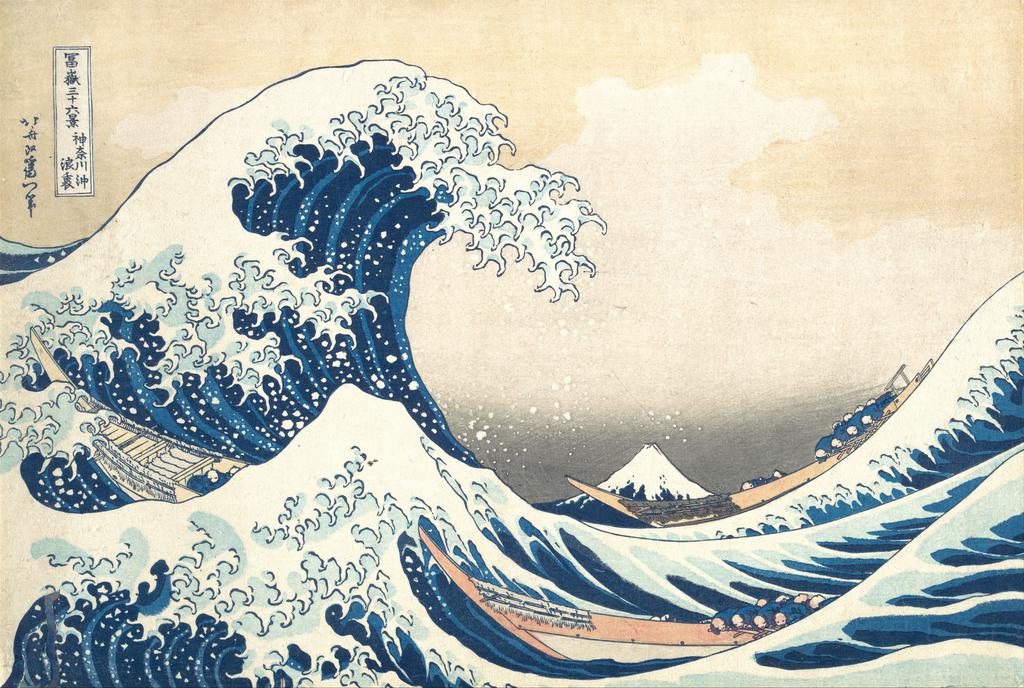
木刻参考
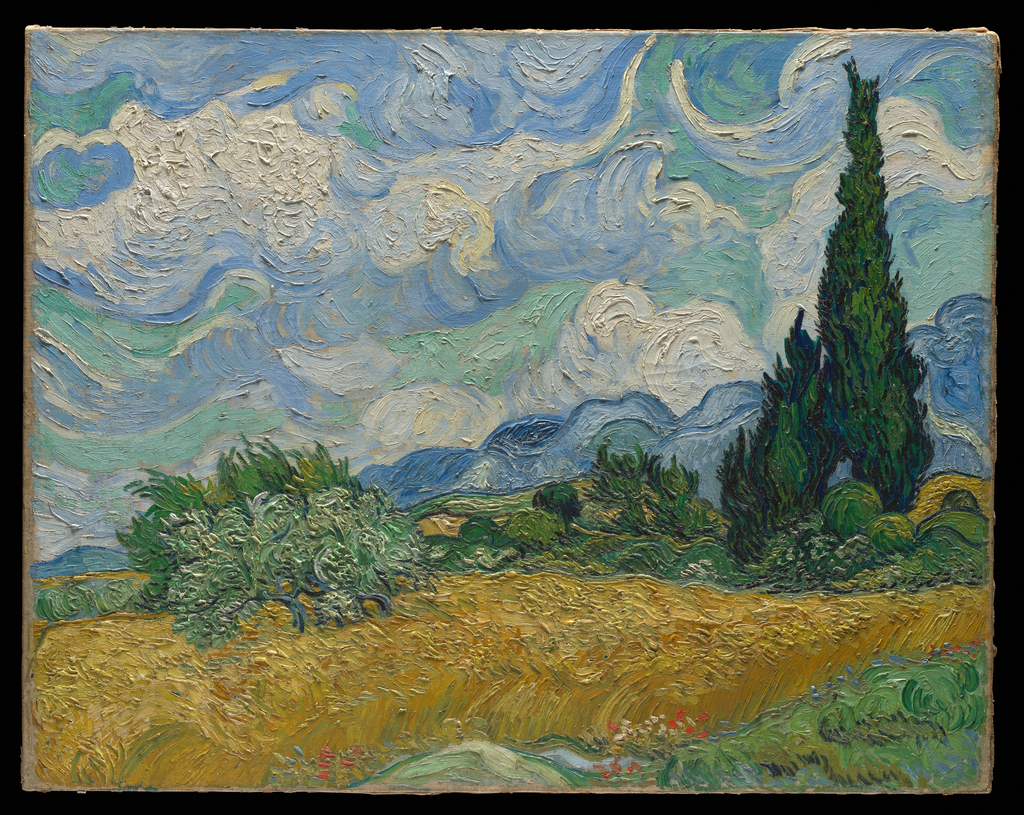
油画参考
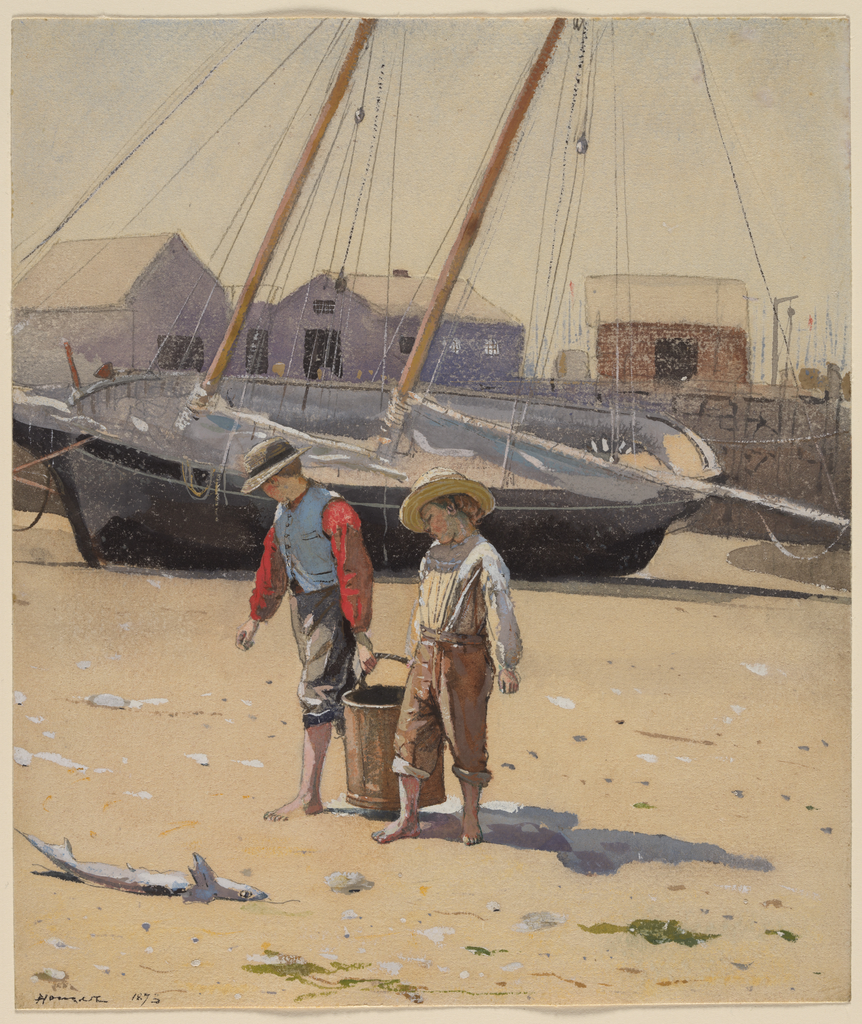
水彩参考
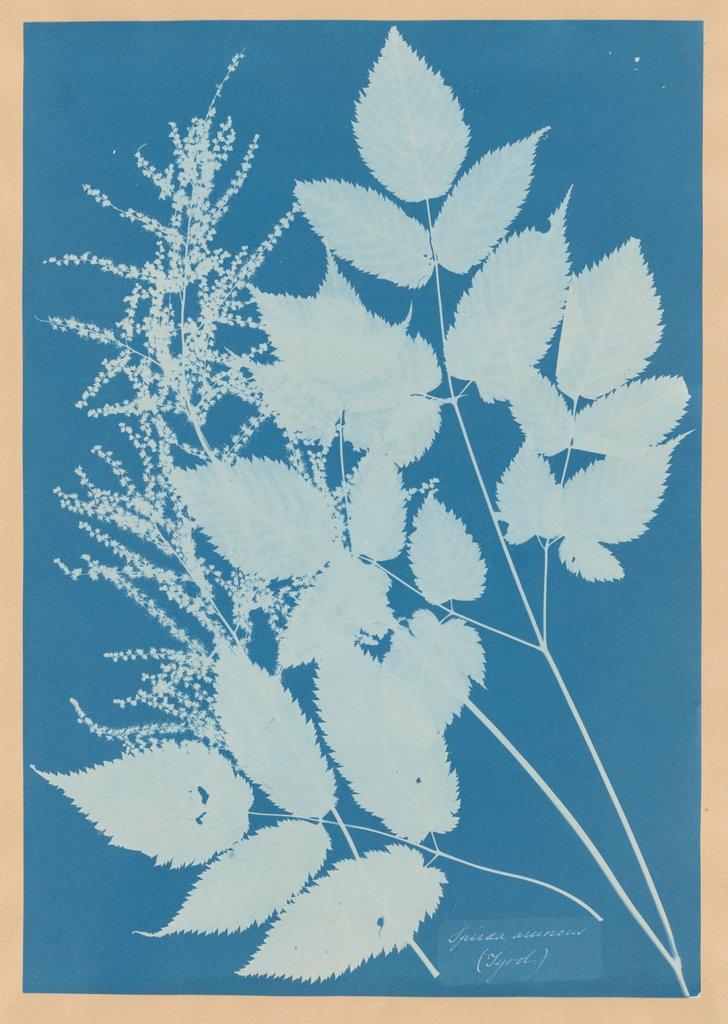
蓝晒参考
观察:参考图变化会带来颜色、线条与柔和度变化,但厚涂笔触、水彩晕染和蓝晒媒介并不稳定。这是选出的定性案例,不代表总体成功率。原始输入在生成时曾被缩放为正方形;本页按原比例展示,不改变已有输出。
固定画风 A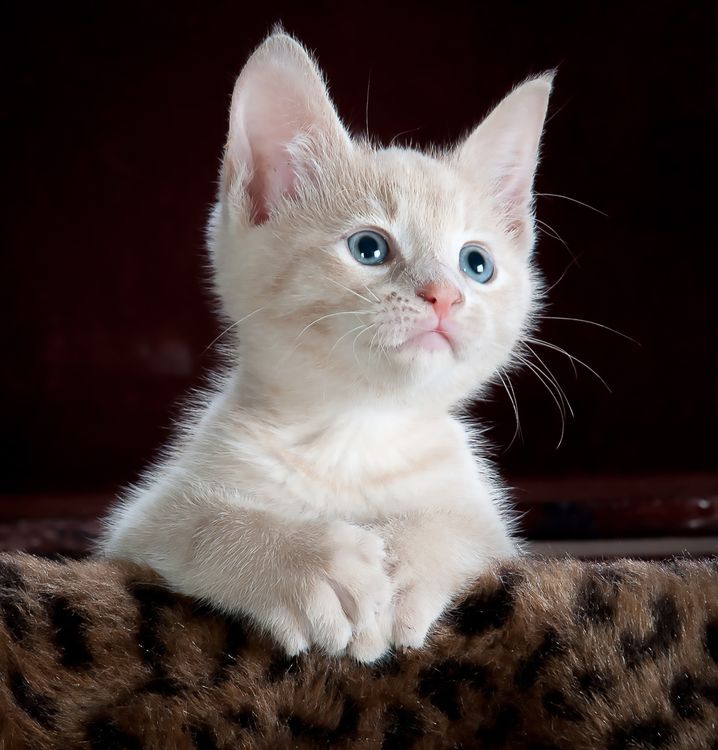
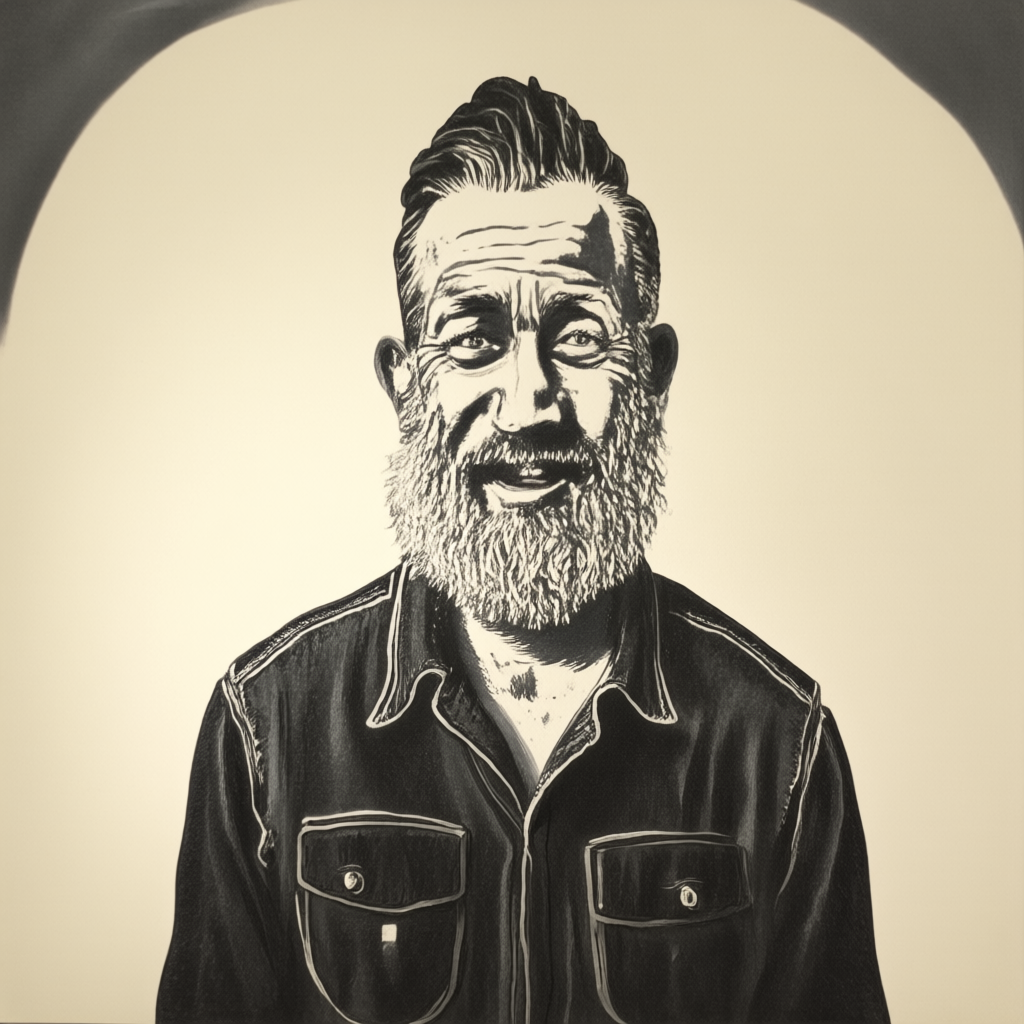
固定木刻参考 A 与 seed 20261014,切换三张内容 B;每张输出右上角为对应的 B 原图。结果用于观察内容保持与画风响应,不代表泛化成功率。
本项目探索将参考画风 A 与内容 B 分开输入 Anima,并通过单个 LoRA 调整画风迁移行为。已有实验表明,替换参考图会改变生成图像;但“参考产生响应”并不等于真实笔触已经迁移,也不证明内容与画风在内部表示中完全解耦。
现阶段我们同时展示有效响应和失败情况,结合受控条件、图像对照与特征空间统计检查模型行为。不同特征代理得到的结果可能不一致,需要以实际生成图和进一步的独立评估共同判断。
训练数据、条件路径与实际算子
目标是让输出保留内容 B的主体和构图,并响应画风参考 A。训练时另有配对目标 C:参考 A 与 C 选自同一风格标签、不同内容组,并要求 A ≠ C;这个选取规则并不能保证语义完全独立。
推理时没有 C;目标槽从噪声开始,结合 B、A 与固定任务提示词进行多步采样。输入分槽不等于内部表征已被证明解耦。
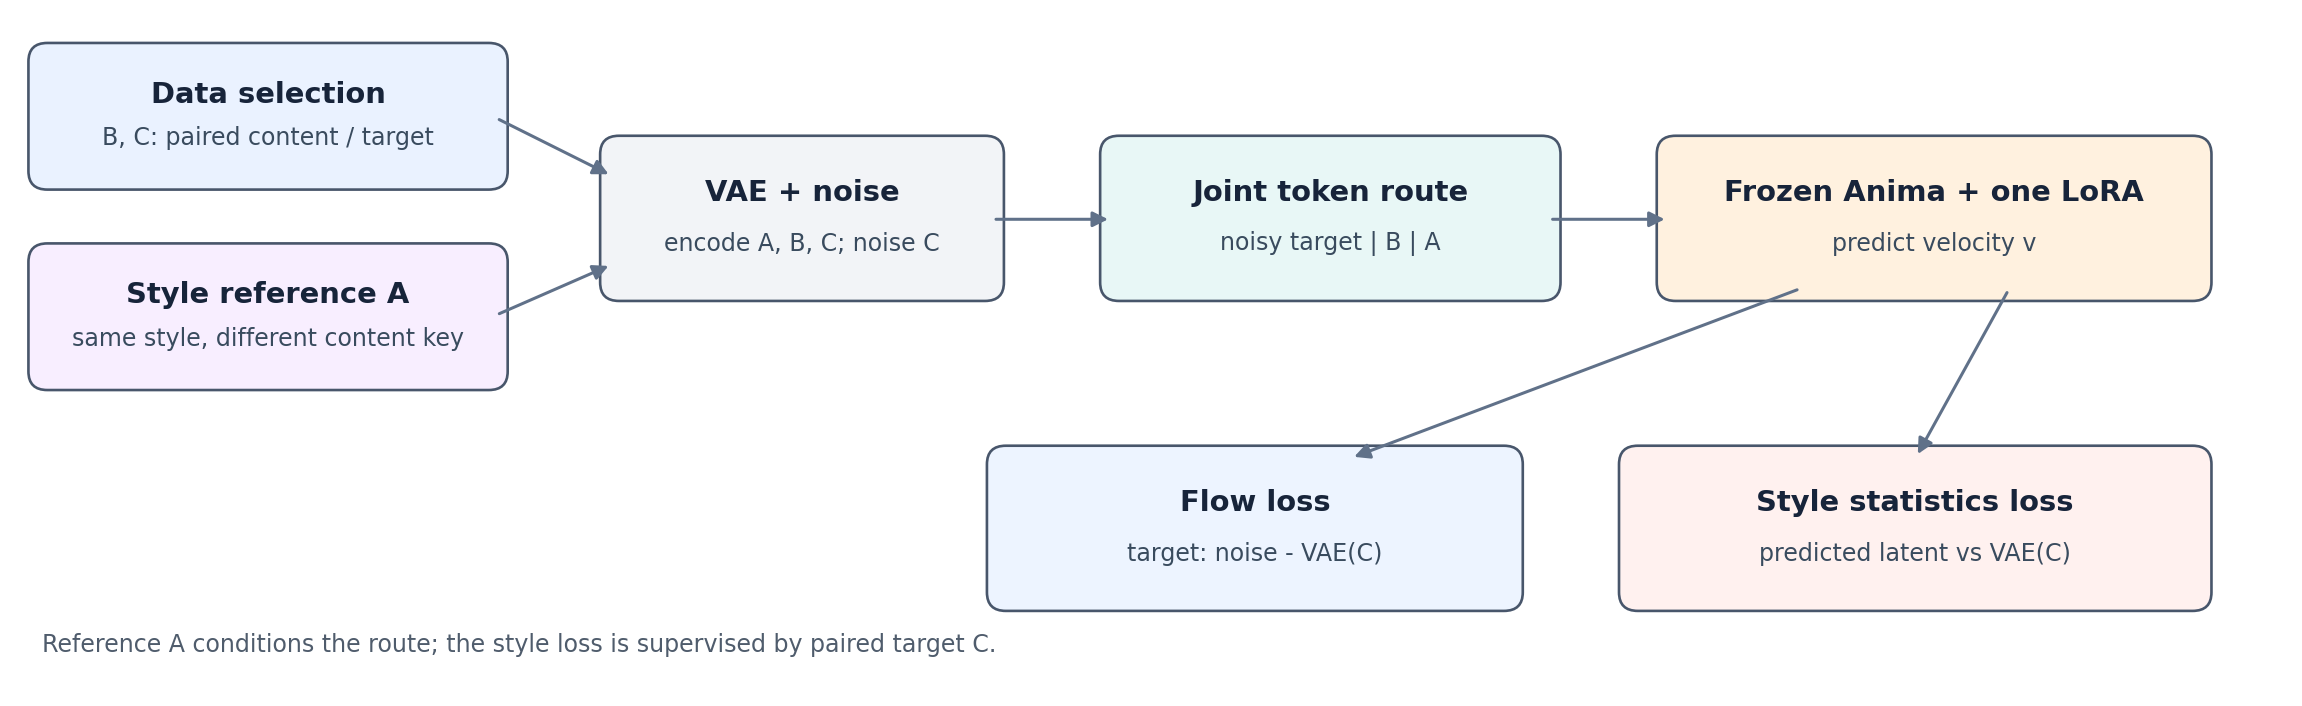
把 C 编码成 latent,与随机噪声按 t 混合。模型接收带噪目标、B 和 A,拟合目标速度;训练时再由单步预测构造画风监督。
t 的采样:g ∼ N(0, 1),u = sigmoid(g),t = 3u / (1 + 2u)。ẑ0 是训练中的单步估计,不是最终多步生成图。
对 latent 在 1、2、4 三个尺度做平均池化;Gram 比较前按通道中心化和标准化;均值与标准差在原池化 latent 上计算,另比较水平/垂直一阶差分统计。ρ 表示 Smooth L1 均值。
监督的直接比较对象是 ẑ0 与 C,不是输出与 A 的局部笔触逐块对齐。边缘项还包含差分特征 Gram,以及绝对均值、平方均值和标准差的比较。
9999 续训配置中 λflow = 1.25,λstyle 初始配置为 0.08;恢复控制器后首个记录值约 0.08087。0.15 是加权风格梯度范数/加权 flow 梯度范数的控制目标,不是固定画风 loss 权重。梯度只在部分审计步与选中样本上测量,实际比值不保证每步达到该目标。
实现与公式依据:论文源码 Method · 理论背景:Flow Matching · LoRA · 神经画风统计
一轮续训的数据如何组成,参数如何落地
训练配置指向本地 style_expert40k.tar;项目作者提供的 StyleExpert 数据集页面将数据描述为内容、参考与风格化结果的集合。我们尚未独立核验本地归档的来源及确切版本,不能把公开数据卡的总量直接当作本地使用量。数据卡标注 CC BY-NC 4.0,公开使用时应核对全部相关条款与素材许可。
一条训练记录由内容 B、配对目标 C 和参考 A 构成;A 与 C 使用同一个画风标签、不同内容组,且 A ≠ C。A 作为条件参与预测,流匹配和风格统计项的直接监督目标来自 C。相同标签不等于笔触完全一致,也不保证内容与风格独立。
清单按风格标签划分 train / validation / test:140 / 30 / 37;名称没有交集。像素级查重检查在这轮代码中处于关闭状态,近重复、视觉相似风格和底模预训练见过的图片均未排除。
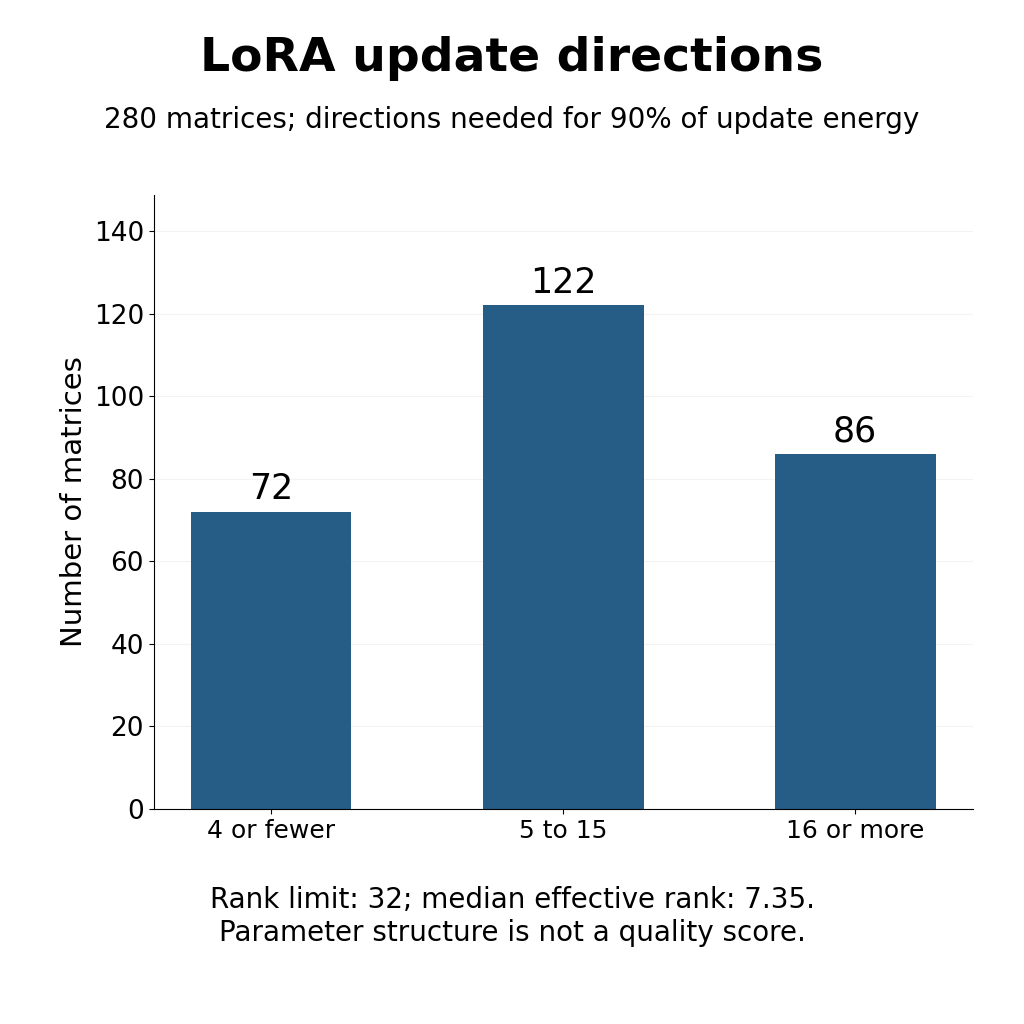
从 global step 9999 继续训练单个 rank-32 LoRA,底模冻结。1024 分辨率,等效 batch 16、microbatch 1,使用 7 个 checkpoint blocks;AdamW 参数为 β=(0.9, 0.999)、ε=10⁻⁸、weight decay=0。历史训练图像按 1024×1024 直接缩放,可能改变宽高比。
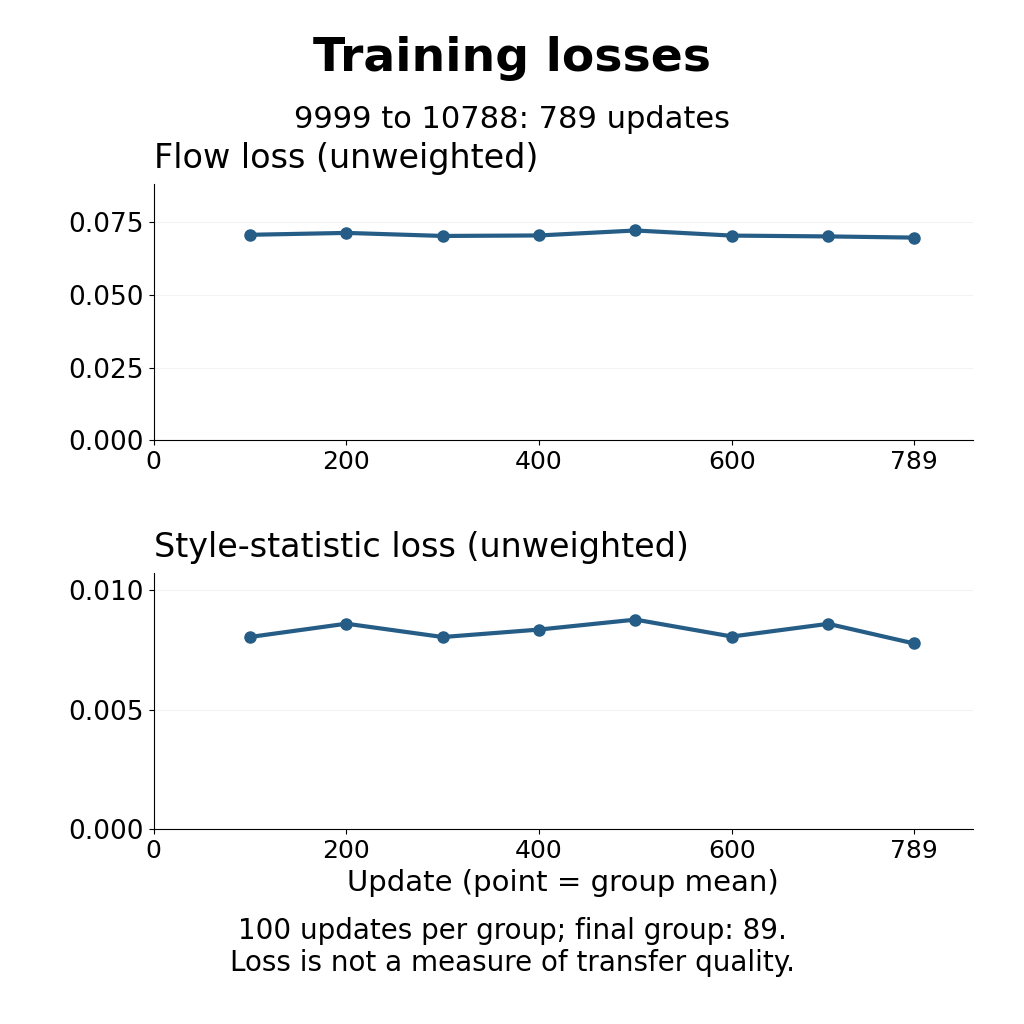
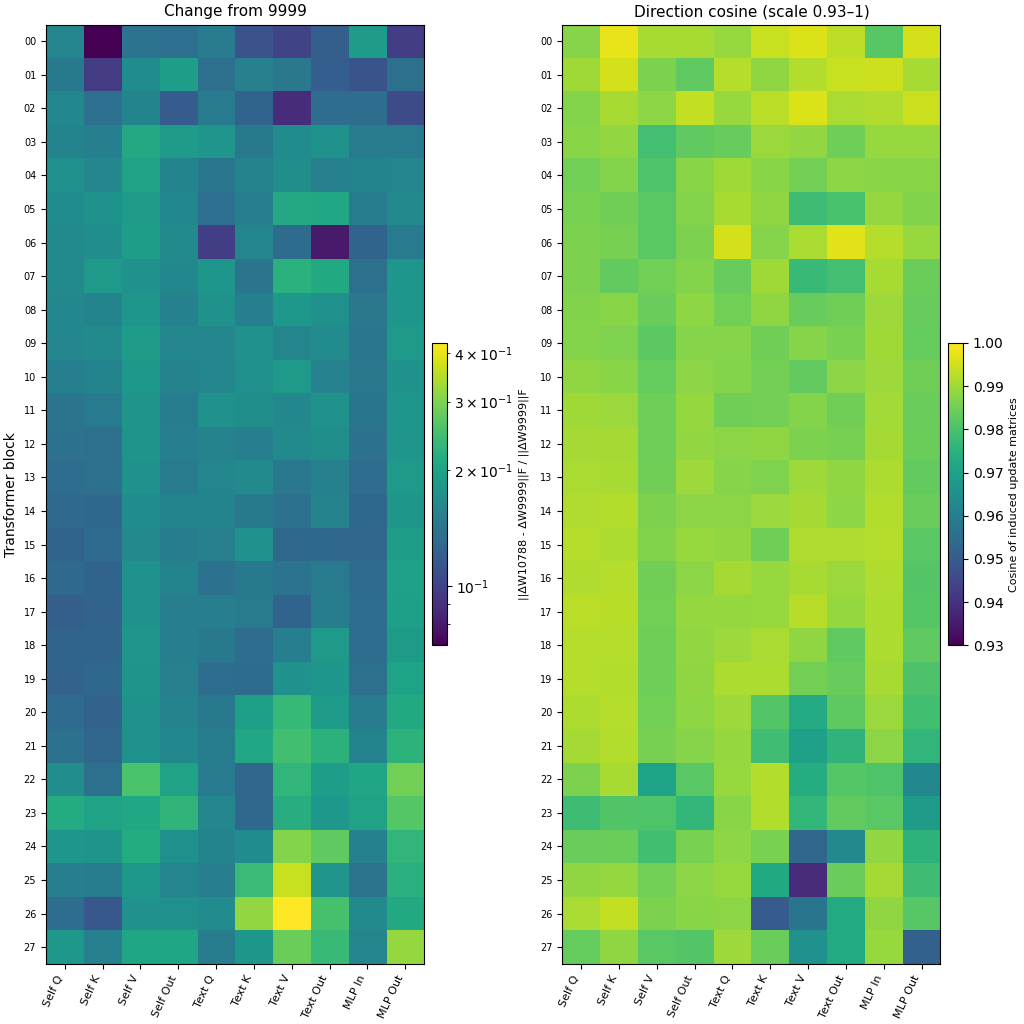
学习率由 1×10⁻⁵ 预热至 5×10⁻⁵;配置最多更新 1000 次,现有日志记录 789 次,结束于 10788。配置为每 100 次预览、每 200 次保存;这是配置,不代表每次执行都一定产物完整。
归档中有 9999 基线、10099 和 10499 等训练预览,固定计划包含训练锚点以及留出内容/标签案例。总览保留 B、C、A 和对应输出;标签或内容被计划留出,并不证明底模从未见过相似画风。
预览原图包含人物与训练参考,来源和公开权限还需逐图核对,未放进当前网页发布目录。下方训练曲线和示例图均来自已留存结果。
9999 续训预检记录 GPU 为 NVIDIA RTX 6000D,可见显存约 83.05 GiB;PyTorch 2.12.0+cu130、CUDA 13.0。配置的显存预算为 76 GiB,它不是实际已用显存。
789 条训练日志中,单次更新的记录耗时中位数约 36.20 秒;该计时覆盖样本准备和更新,不包括额外的预览及保存开销。单步 PyTorch 峰值已分配显存最高约 39.06 GiB,不等于整机占用。CPU 和操作系统型号尚未核实。
依据:本地训练计划 data_plan.json、report_84g.json 与逐步日志;可查看本项目内配置摘录、记录汇总、逐步数据和保留的运行时代码。上述原始归档尚未随网页公开。
我们实际训练过什么、得到什么、又排除了什么
历史记录包含多轮单 LoRA 强化和外部交叉预测。早期 checkpoint、输出和训练增量没有完整留存,不能将每一阶段的视觉变化归因于某一次改动。
分辨率 1024,等效 batch 16,rank 32;LoRA 学习率由 1×10⁻⁵ 预热至 5×10⁻⁵。主 loss 与画风 loss 分开记录;分段曲线不能代替生成图质量。
原 LoRA 冻结。云端记录 9600 次样本呈现、140 个风格标签;云端 0/400/600 步(累计 300/700/900 步)预览未建立稳定的外部笔触改善,部分案例有内容漂移。
在 LoRA 10135 和已有卷积分支上继续训练,12 组 B/A 各比较增量 OFF/ON,一个种子。粉彩边缘、水墨纸感有局部响应;点彩、蓝晒仍不忠实。未建立动态增量的稳定额外收益。
排序项仅在 3/15 步激活;配对纹理干预也只触发 3 次。少量预览未建立可靠改善,但不足以否定整个方法方向。
3 张图各做 60 次像素空间优化,StyleShot 相关距离下降约 80%–87%,视觉复核均未通过。该实验中 Anima 和 LoRA 更新次数为 0。
综合评测原计划 1232 条,本地档案记录 600 条;本页只报告实际留存的记录和明确标记的子集。
历史 LoRA 10135 分支对照:同一 B、A 与种子下,比较动态增量 OFF / ON。
输出可见局部粉彩感;动态增量带来的额外改善尚未建立。
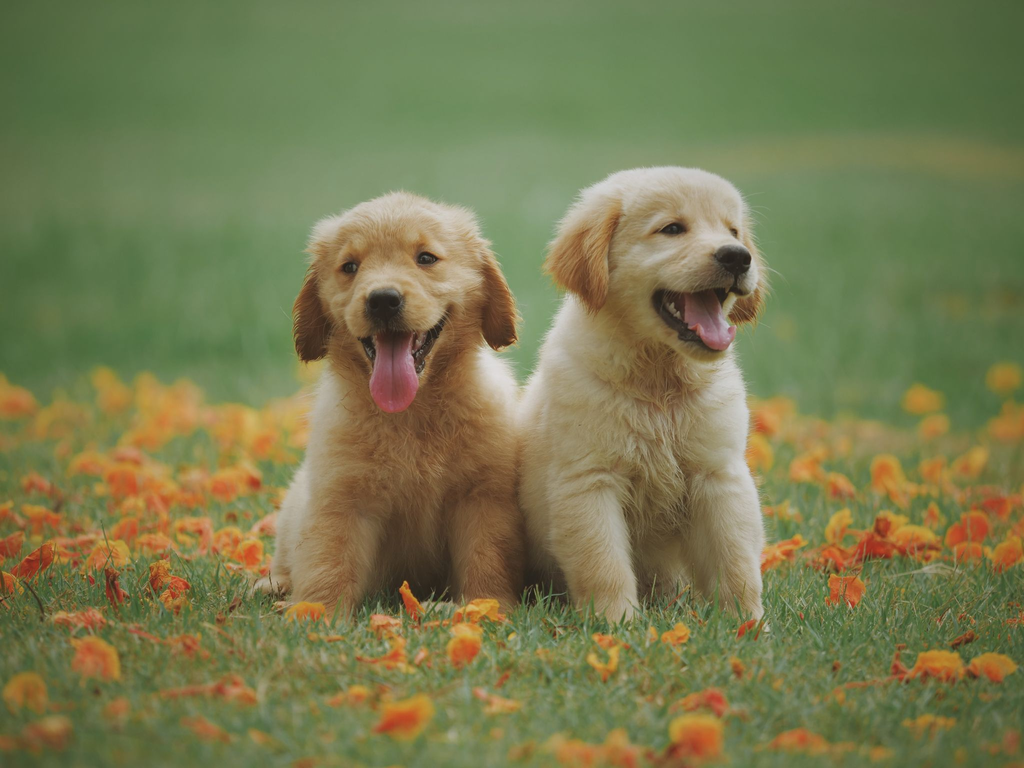
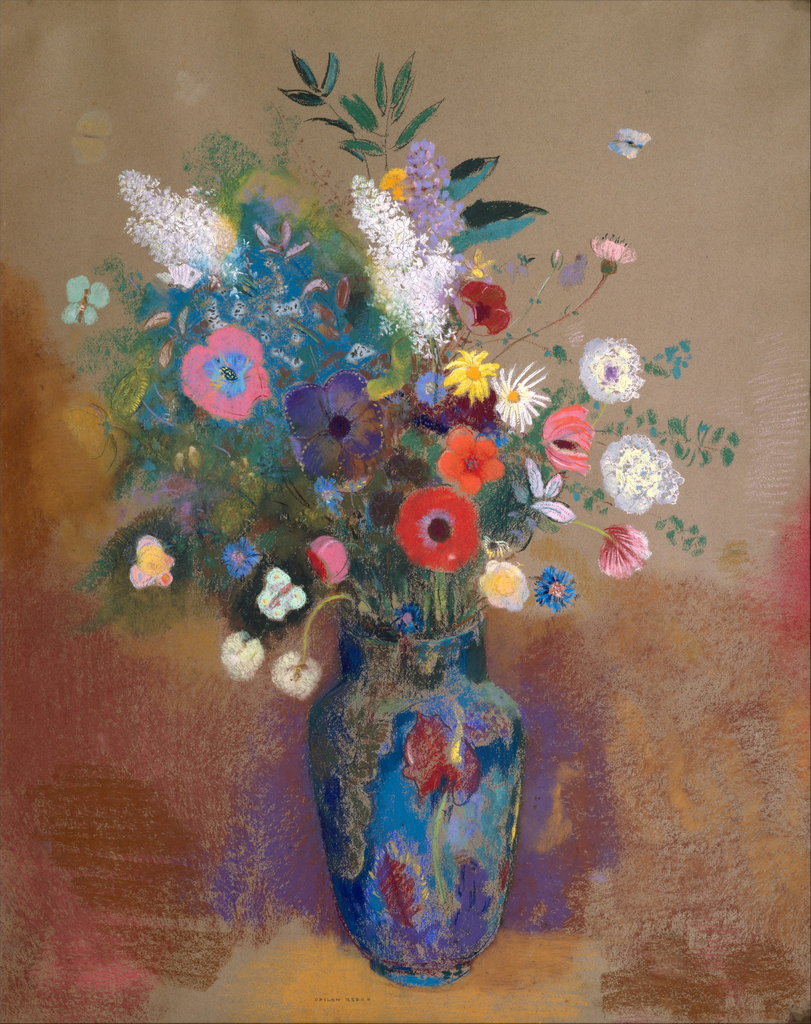
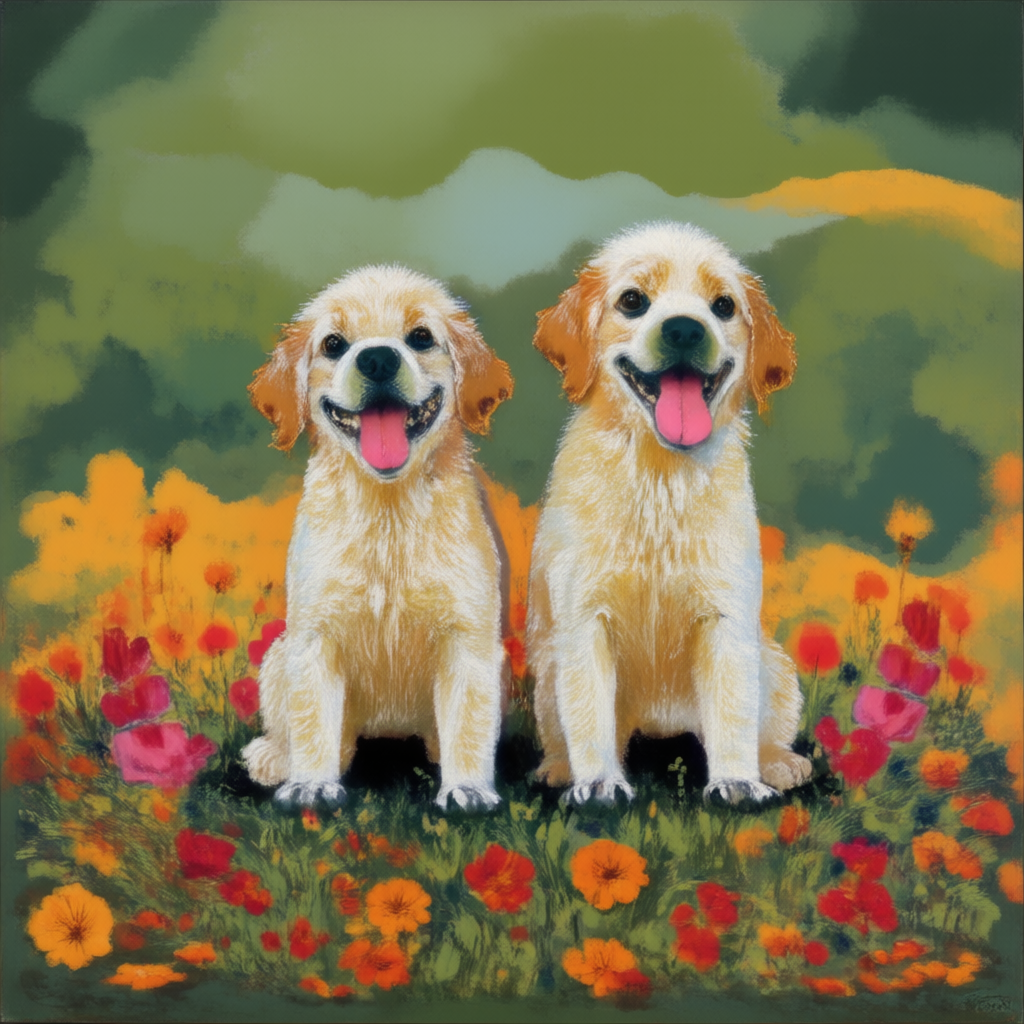
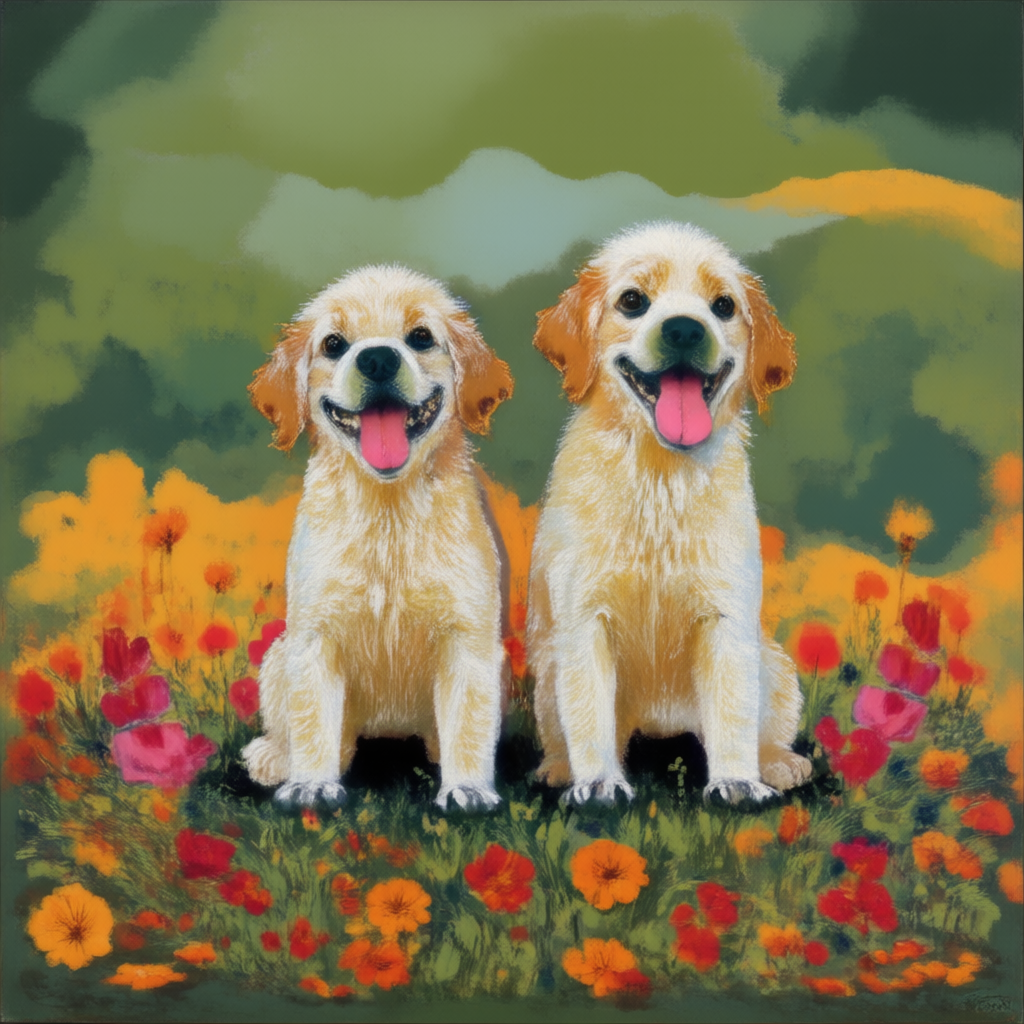
输出仍保留多种颜色,未忠实复现参考图的蓝晒媒介。
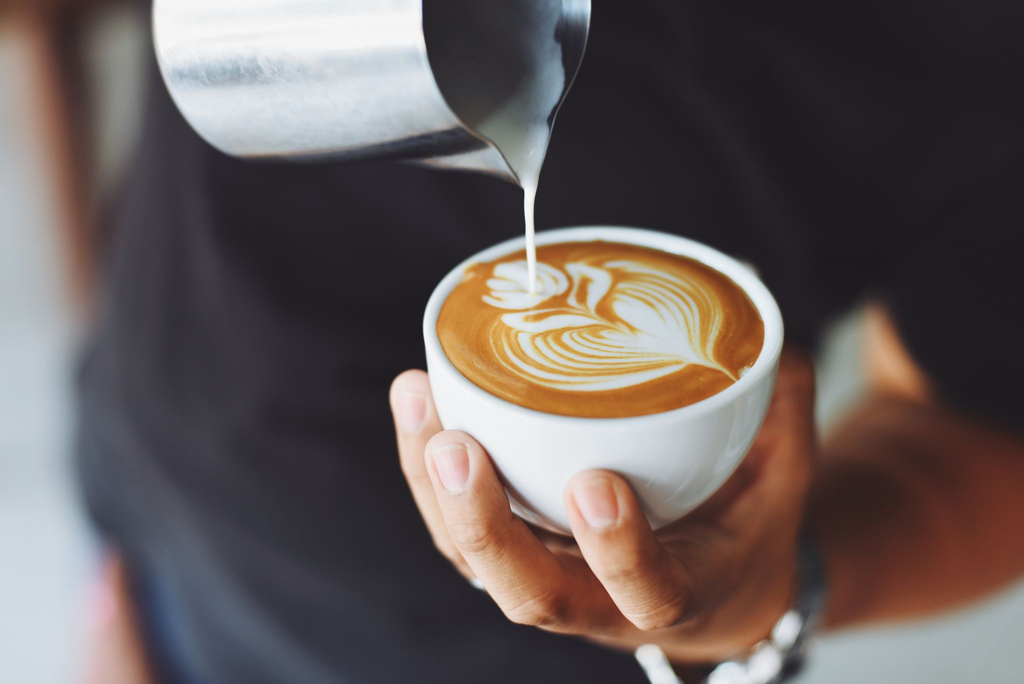
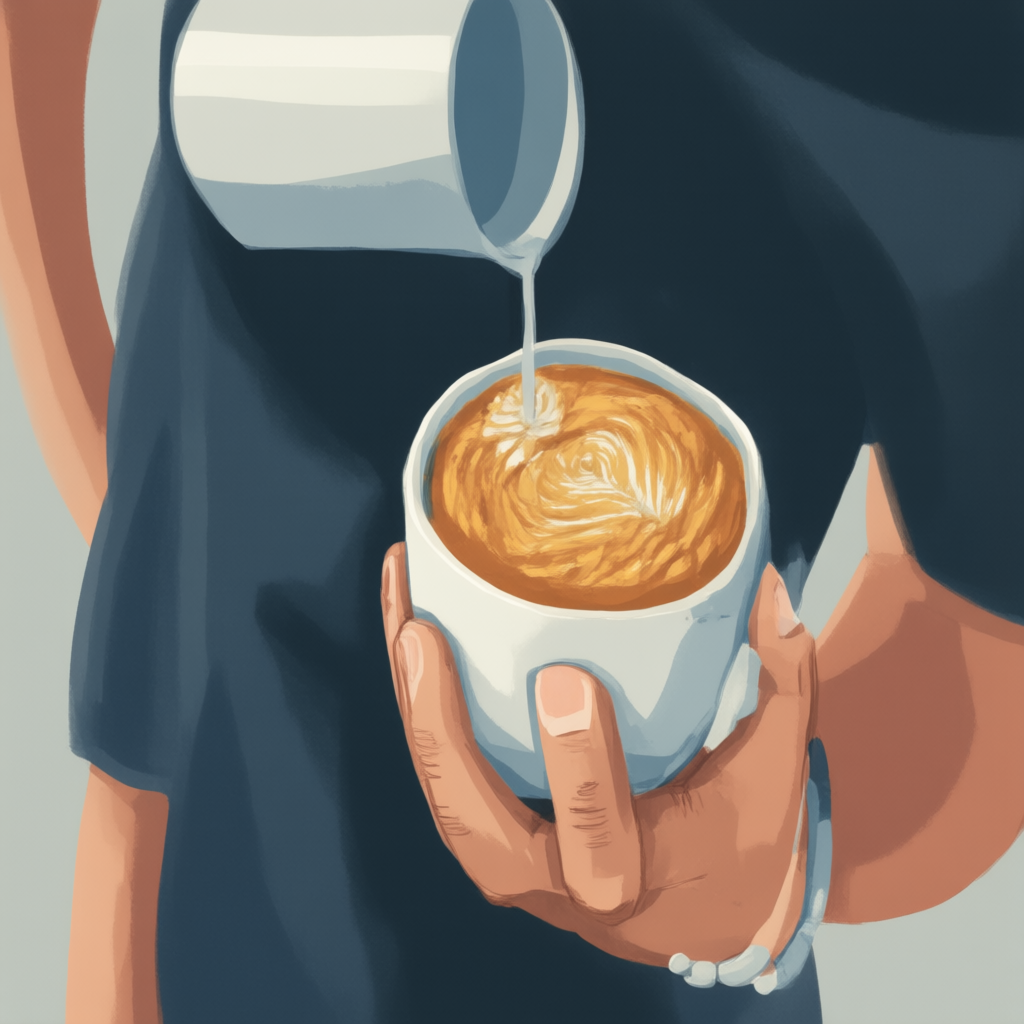
两组均为 seed 20261014、30 次采样。OFF 仅关闭新的动态增量;原 LoRA、旧卷积分支与参考条件两边均保留。完整历史对照有 12 组,这里为事后选取的示例。历史推理时输入曾被拉伸为正方形;此处仅按原比例展示原图。
另有四组历史合图;其中植物照片来源尚未核实,合图暂不公开,原始研究档案仍保留。
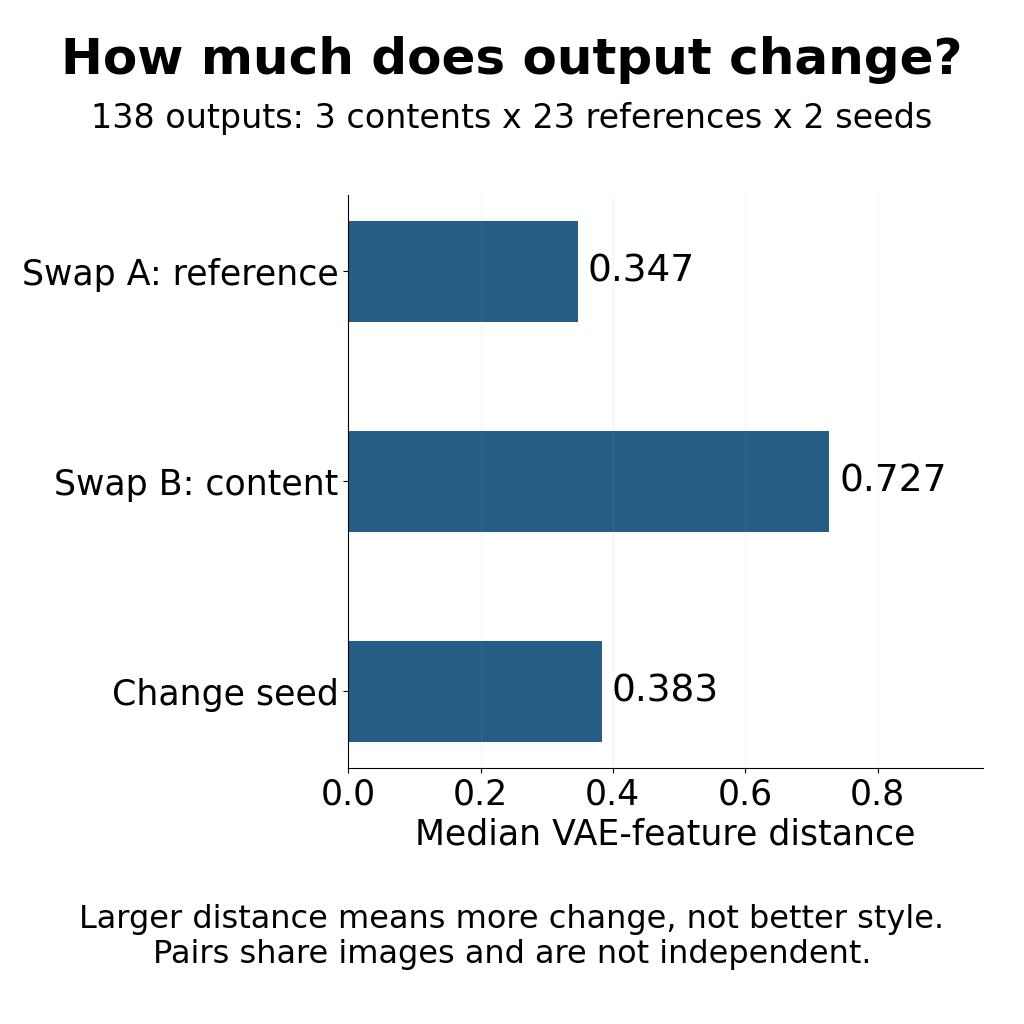
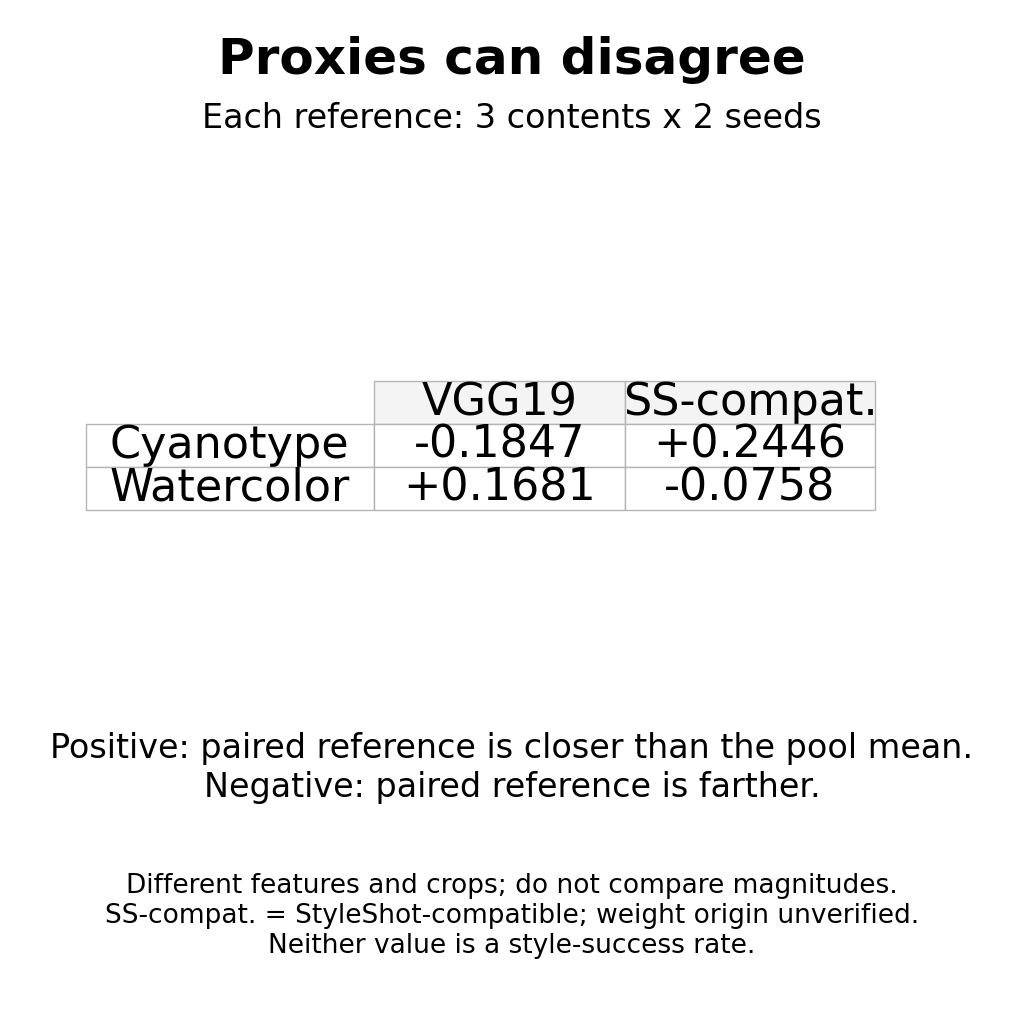
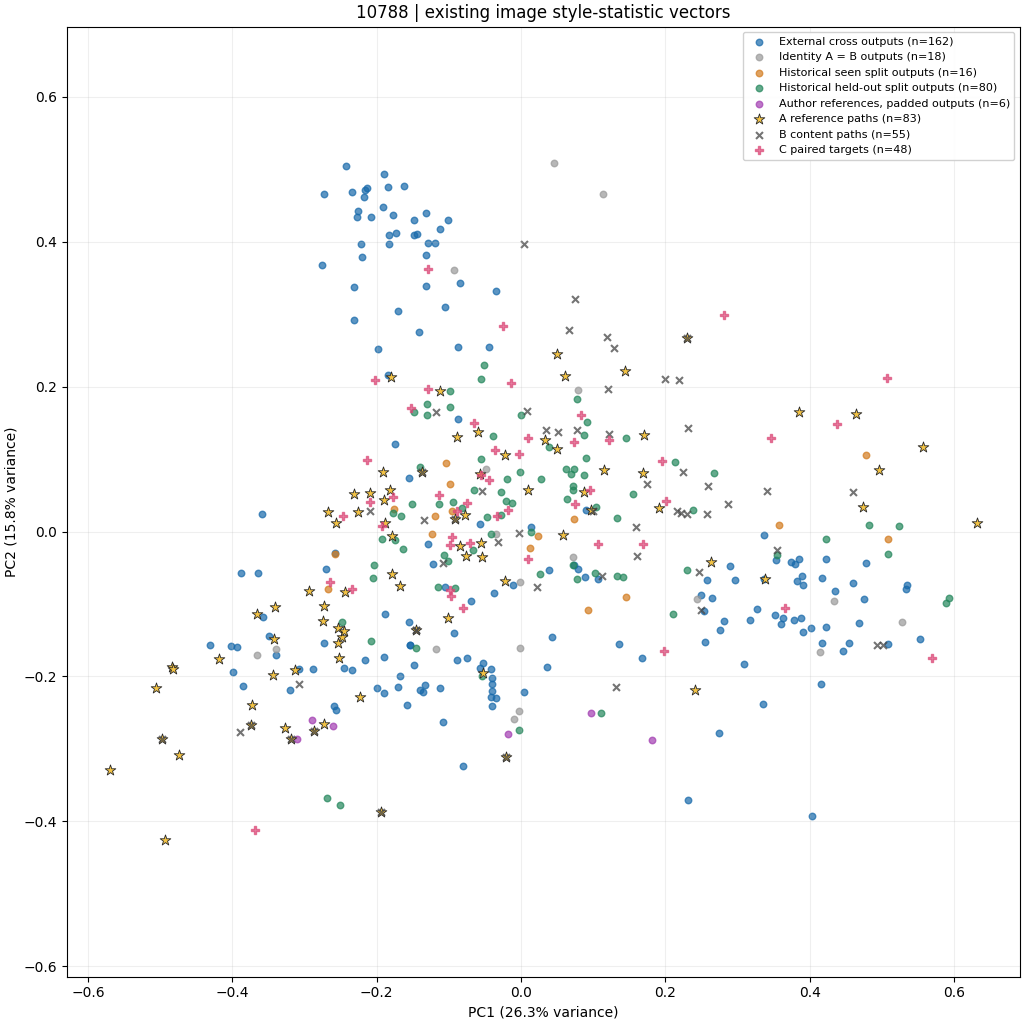
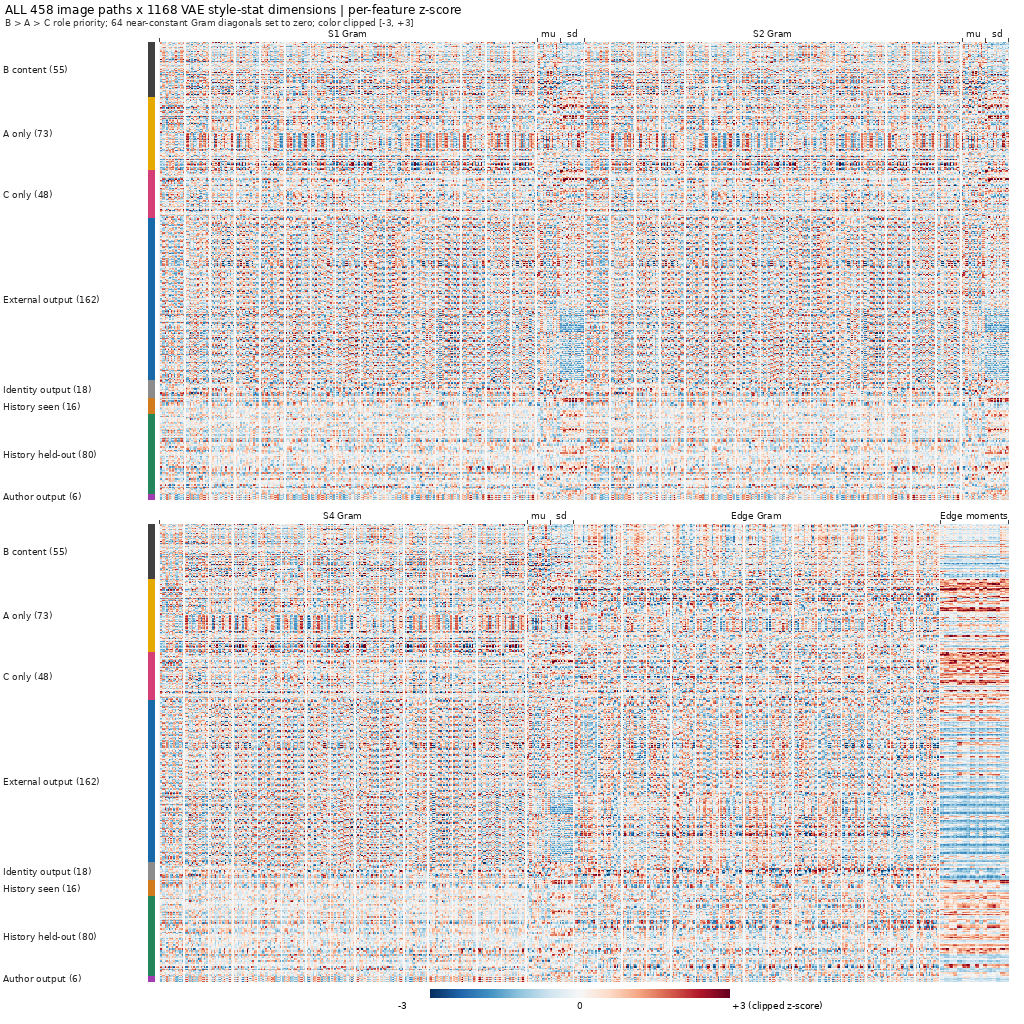
在已记录的 3 个内容、23 张参考和 2 个种子组成的 138 张输出中,固定内容与种子后更换 A 会改变输出特征。下图是同一 VAE 特征空间的匹配条件距离中位数,仅表示特征变化大小,不是风格成功率或解耦率。
特征包含颜色、主体及构图;保留内容本来也是目标。匹配对照共享图像,不能当作独立样本;不同测量模型的数值尺度不能直接比较。对同一蓝晒参考,VGG 与 StyleShot 兼容编码器给出的相对匹配方向相反。缺少严格封存测试集及独立盲评,暂不能报告泛化胜率。
从生成图、参数和中间状态三个层面检查
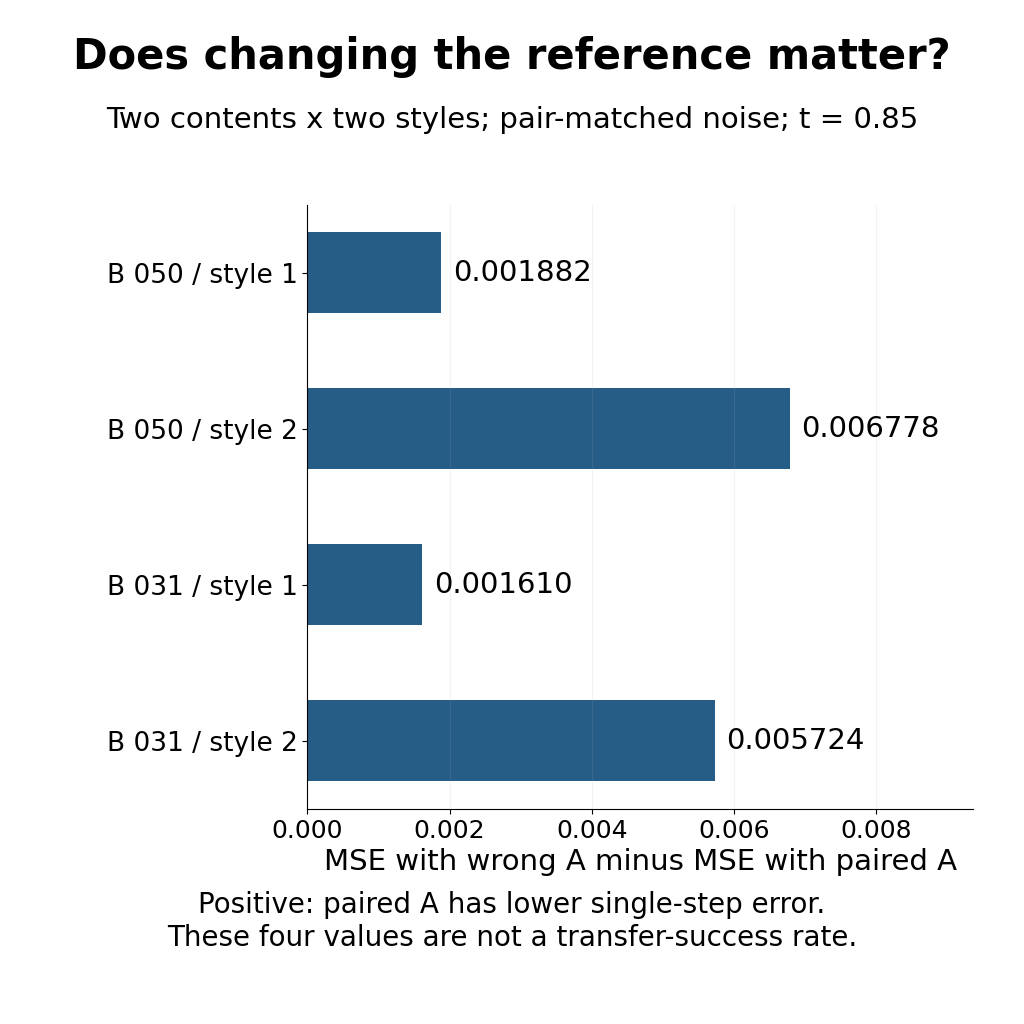
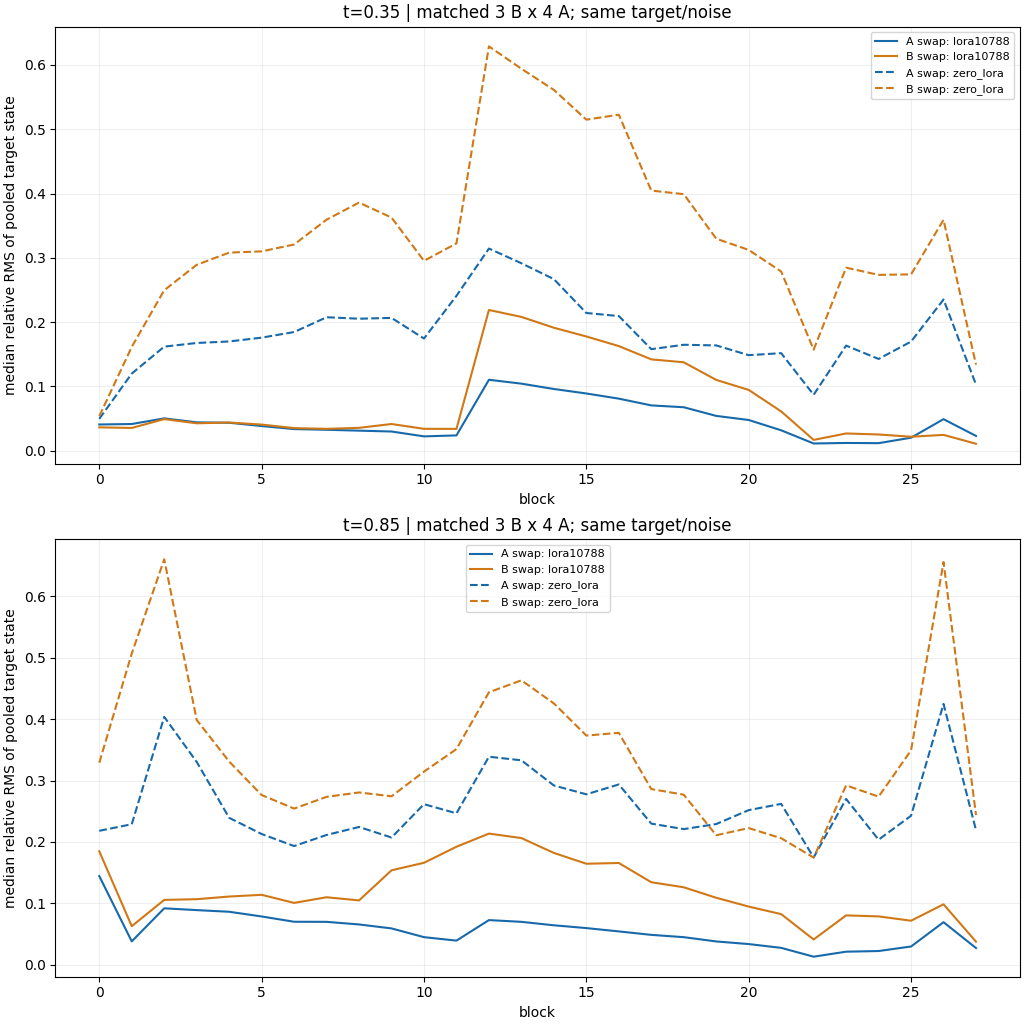
历史 2×2 单步干预中,固定 B、C、噪声和 t = 0.85,分别替换正确/错误参考。四组“错误 A 的 flow MSE − 正确 A 的 flow MSE”均为正:0.001882、0.006778、0.001610、0.005724。这个小实验支持条件响应存在,不能证明画风已迁移。
把空间位置展平后,令 P 为置换矩阵。通道 Gram 对空间重排不敏感:
一个实际的方形 latent 转置实验中,相对 RMS 变化为 1.16,现有 style loss 却只有 5.96 × 10⁻¹⁴。这证明该测试中的统计量对这种结构变化不敏感;latent 转置不是现实图像旋转,flow loss 也不一定不变,不能将它当成泛化失败的唯一原因。查看原始汇总
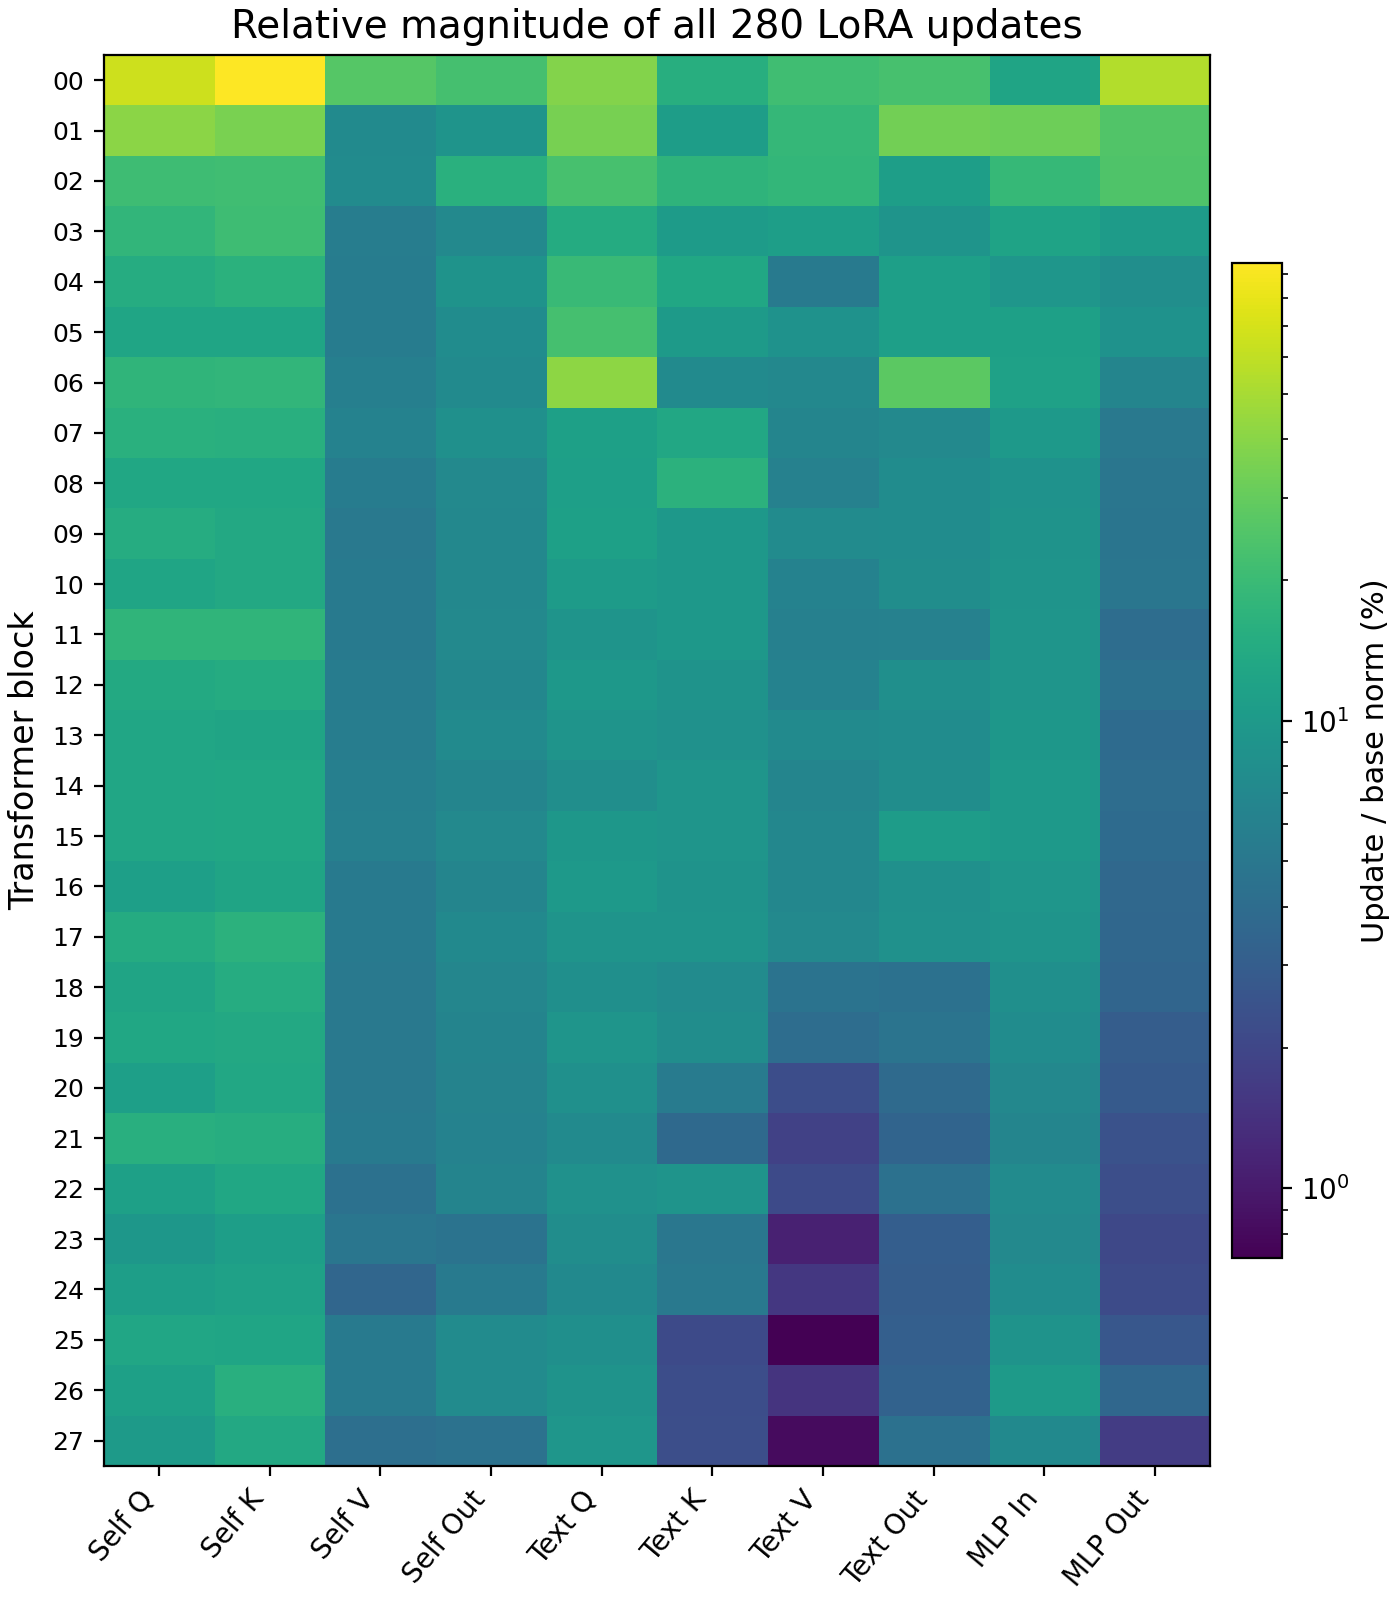
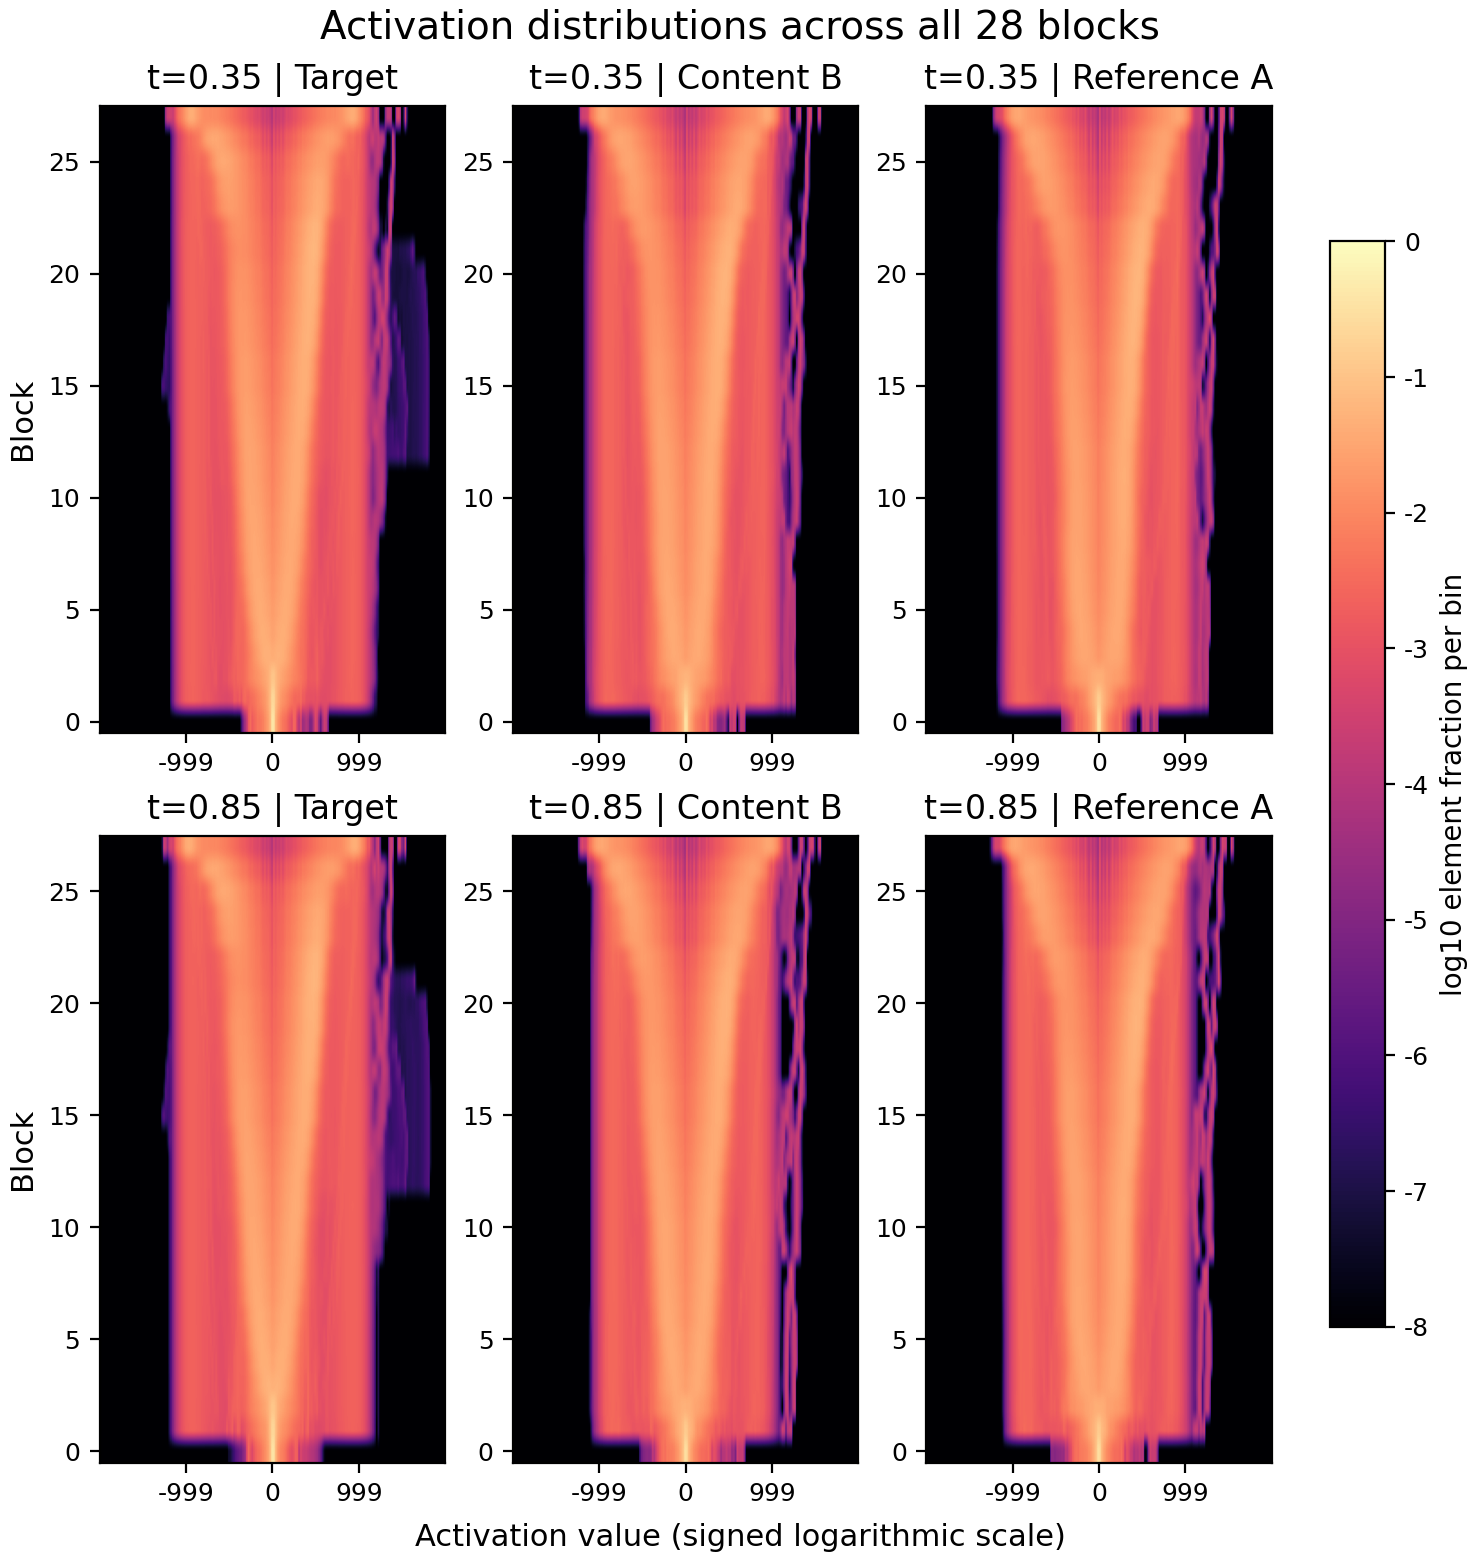
28 层状态分布。总共执行 174 个单步条件;本图每个 t 面板只汇总 69 个外部条件。各层归一化分母不同,不能用末层曲线较低推断“画风被覆盖”。查看分箱审计汇总
在同一个 LoRA 内尝试目标分解与阶段拟合
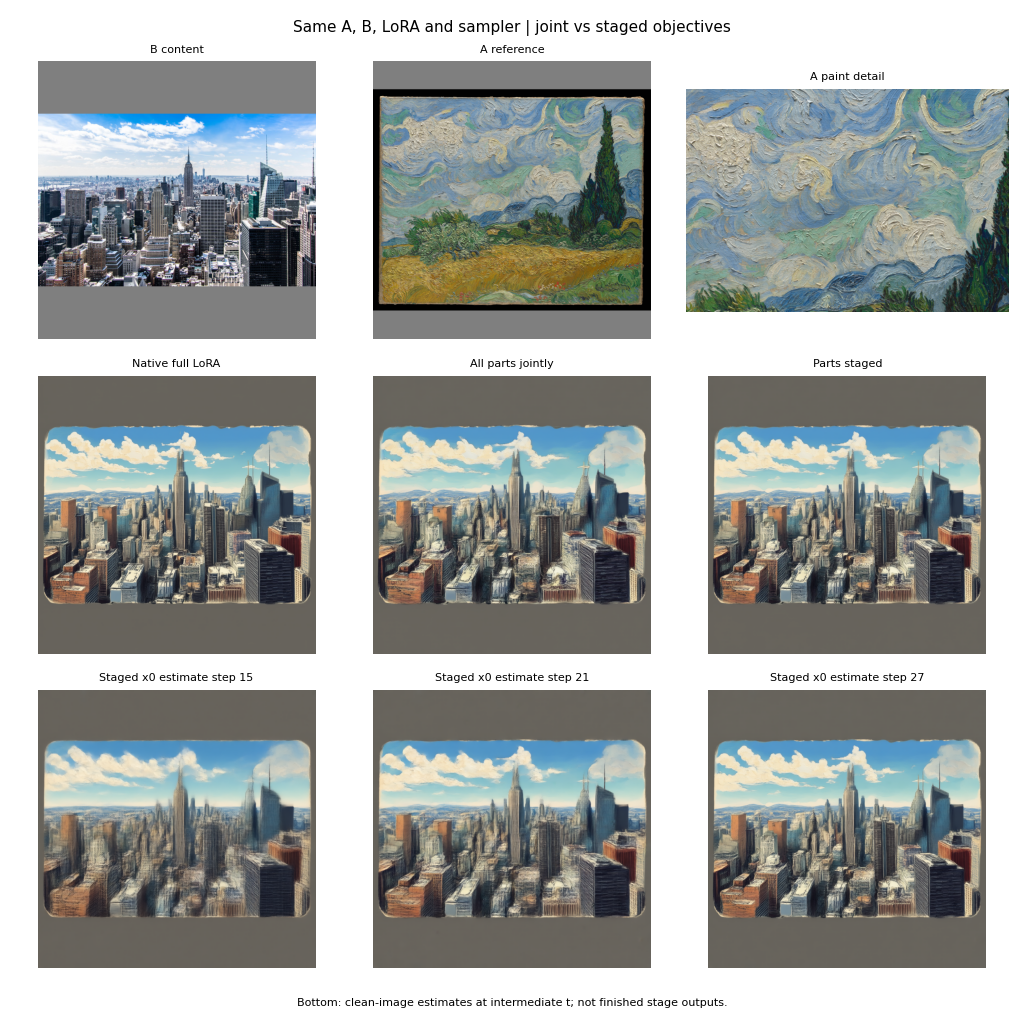
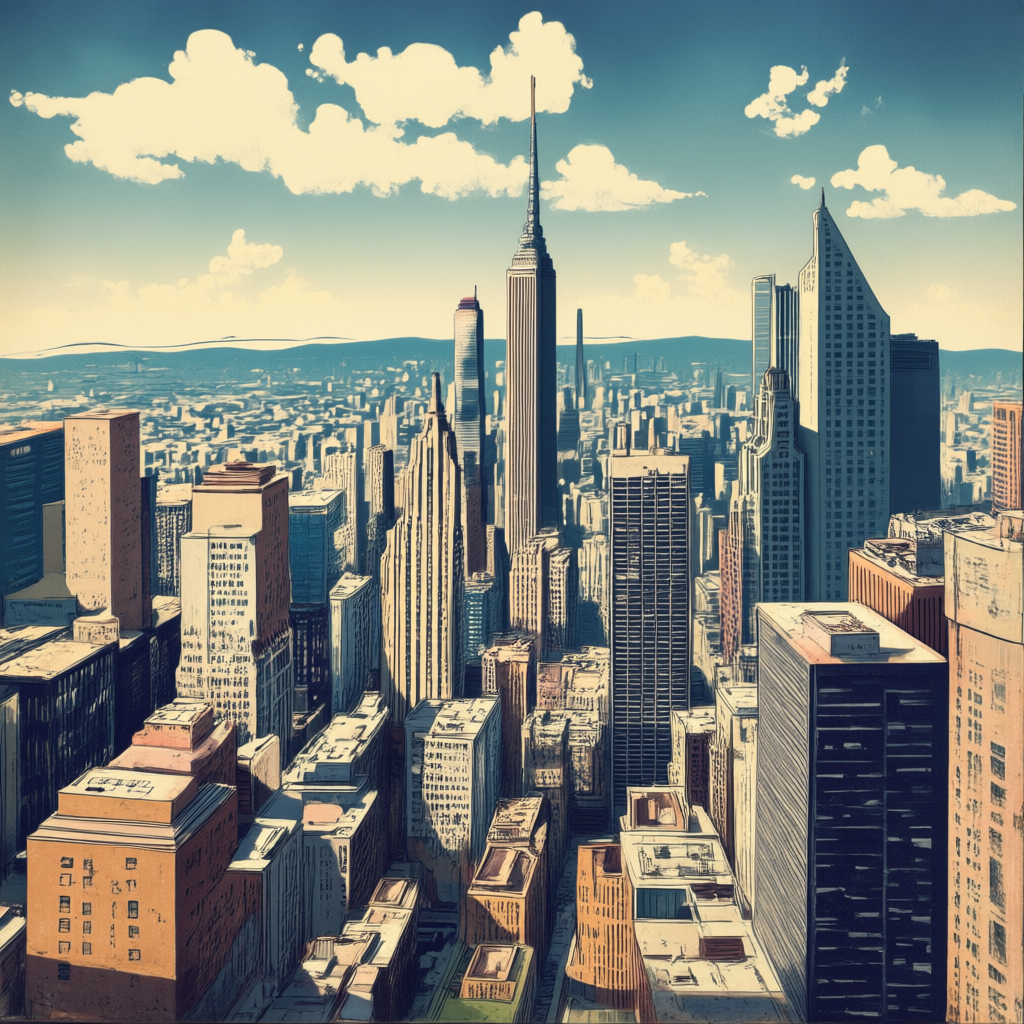
我们用一张油画 A 作为参考、一张城市 B 作为内容,在同一个 LoRA 的一次采样轨迹内,比较原始生成、联合拟合与阶段拟合。颜色直方图、灰度 VGG 方向变化和局部特征距离作为三个参考代理;它们可能混入主体轮廓和亮度,不是已证实可以独立拼接的画风原子。
在 15、21、27 三个采样位置,使用同一组候选调整两个互补谱分量;联合路径每次考虑三个代理,阶段路径逐步加入代理。两条路径使用相同 A、B、seed 和 30 步采样;每条额外执行 9 次候选前向和 12 次 VAE 解码,原始基线计算量更低。没有更新训练参数。
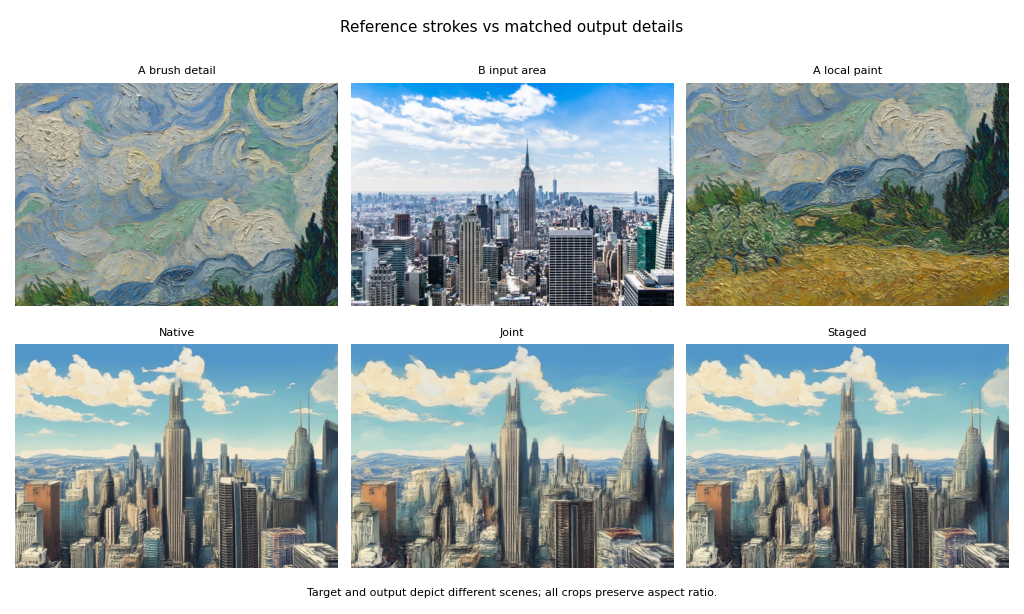
真实局部对照。上排是油画笔触局部、城市内容局部、油画另一局部;下排依次是原始 LoRA、联合拟合、阶段拟合。视觉上未清楚重现参考的厚涂弯曲笔触,且重绘了一些城市细节。
| 路径 | 颜色误差 | 方向误差 | 纹理代理误差 |
|---|---|---|---|
| 原始 | 0.04381 | 0.01173 | 0.11174 |
| 联合 | 0.04234 | 0.00979 | 0.10036 |
| 阶段 | 0.04321 | 0.01055 | 0.10407 |
值越低只表示对应代理更接近参考;不是画风成功率。两个谱分量多数被同时加 0.35,近似于图像侧 LoRA 统一放大 1.35 倍,阶段差别主要是介入时间;这个单例不能证明学到了独立画风基底。查看实验记录 · 查看完整图与阶段估计
先验证局部描述符是否能让“同风格、不同内容”比“同内容、不同风格”更接近;再固定 B、A、种子和计算预算,对单 LoRA 的训练方法做配对实验。保留完整图和原尺寸笔触裁片,区分视觉观察与代理分数;当前没有足够证据称该设想已经成功。
研究代码与本地节点,按真实运行路径使用
custom_nodes/AnimaSingleLoRA/,保留 runtime/ 和 native_support/,重启后在 Anima/Research 分类查找节点。LoadImage (B) → content_BLoadImage (A) → style_AAnimaNativeStyleTransfer → SaveImage
节点使用 target + B + A 原生三槽路径,不是普通 LoRA Loader。选择 pad 等比补灰边或 center_crop 等比裁剪;输出 1024 × 1024、不拉伸。默认 30 步、seed 20261014;当前固定任务提示词用于保持第一参考的内容并迁移第二参考的画风,不支持任意文本输入。
本地 ComfyUI 在 RTX 3080 20 GiB 上加载 10788 权重,完成 1024×1024、30 步推理;2026-11-07 这次执行约 99.8 秒,包含冷加载。这证明该环境的一次流程可执行,不代表其他设备的速度或画风质量。
节点实现 · 原生训练/推理运行时 · 数据整理代码 · 实验数据说明 · 训练代码与配置 · 模型 SHA-256 附录。
本目录不包含完整训练集和底模,10788 LoRA 在 Release 中提供;完整训练尚不能单独复现。原创代码与第三方资料适用各自的授权条款;已运行不等于画风完全解耦。
从已经踩过的坑,明确下一轮如何避免重复
已观察:像素优化可显著降低代理距离,但三例视觉复核失败。
下一步:同时固定种子看完整生成图和局部裁片,分别记录内容保持、笔触与颜色;把特征分数作为辅助。
已观察:换 A 会改变单步状态和输出,但某些结果主要改变颜色或粗线条。
下一步:固定 B 与种子切换 A,再固定 A 与种子切换 B;继续做同画风异内容、同内容异画风的匹配实验。
已观察:多尺度 Gram 与统计项在特定转置反例上接近不变。
下一步:先验证局部特征能否区分画风与内容,再考虑把有效表征接入训练;这仍是待验证方案。
已观察:动态增量 OFF 仍保留旧卷积和 LoRA;12 对输出的逐像素 RGB 绝对差的平均值为 0.572/255。
下一步:区分“无旧分支”和“仅关动态增量”,固定输入、种子与采样参数,不能把像素差解释为质量提升。
已观察:历史综合生成把输入拉伸成方形;部分后续探针使用等比缩放与灰边。
下一步:训练与测试分别记录缩放、裁剪和填充;页面展示按原比例,比较时只在相同预处理下归因。
已观察:1232 是原计划,已记录 600;138 是匹配子集;底模是否见过这些风格未知。
下一步:先封存按内容与画风独立划分的测试集,再做独立盲评和同协议外部方法比较。
Gatys 等:神经画风表示 · Hu 等:LoRA · Lipman 等:Flow Matching · StyleShot · USO
与 USO 或其他公开方法尚无同任务、同数据、同推理条件的公平重跑;本页不作模型胜负比较。
内容图及画风参考来自以下原始来源;本记录用于追溯,正式公开前仍需逐项核对授权与署名要求。